第 61 卷
综合评分快速判断当前 GEO 基础水平确认评分口径和测试样本,不把一次分数当永久结论。
关键发现找到最影响结果的短板每条发现都要能回到具体平台、具体问题、具体回答。
风险提示提前发现会影响推荐的负面因素区分事实风险、内容缺口和模型误解。
比如 WeSight 仅支持 macOS Apple Silicon 这类产品边界,如果官网、README 和外部资料没有解释清楚,AI 可能会在推荐时附带限制提醒,甚至把它排除在部分用户需求之外。
报告模块二:AIVO 评分,看清短板在哪
把 GEO 拆成四个维度:AI 搜索可见度、基建完善度、竞品对比优势、舆情健康度。这个拆法比单一总分更有价值,因为它能告诉你到底是“没人提你”,还是“有人提你但说不准”,或者“竞品资料更强”。
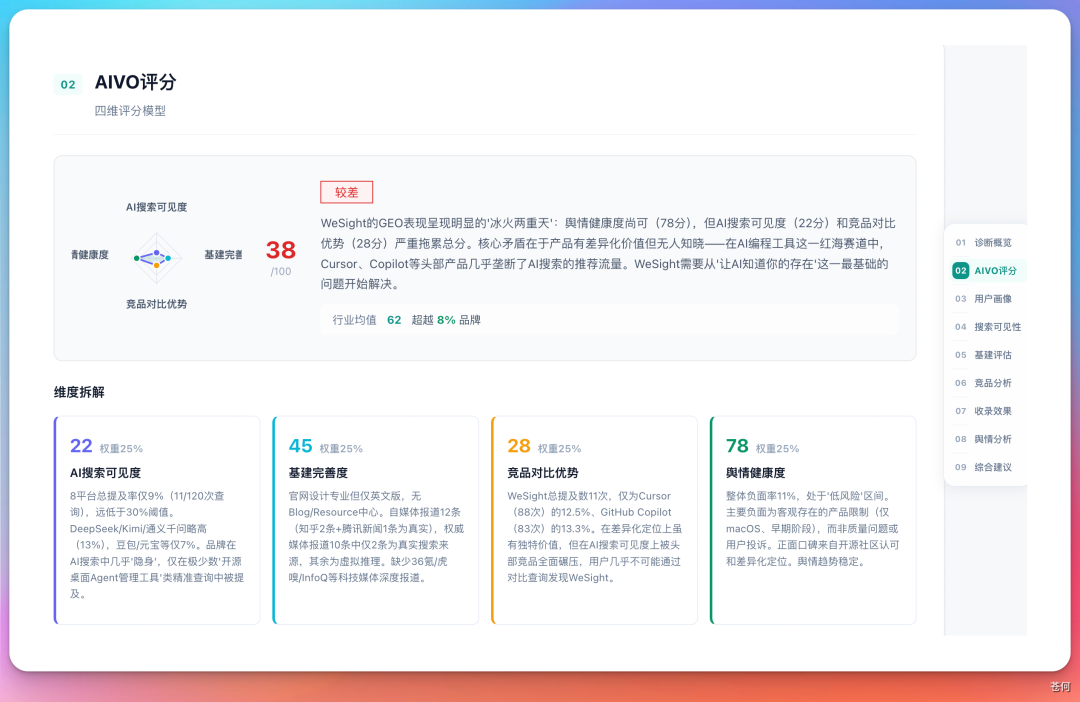
| 维度 | 它衡量什么 | 低分时先做什么 |
|---|---|---|
| AI 搜索可见度 | 用户问相关问题时,品牌被提及的 | 补用户问题对应的内容页、对比页 |
| 比例和位置。 | 和场景页。 | |
| 基建完善度 | 官网、官方账号、技术文档、权威 | 修正官网事实、统一名称、补充结 |
| 来源是否完整。 | 构化介绍。 | |
| 竞品对比优势 | 同一条 query 下,AI 更容易推荐 | 写清差异化、适用边界和与竞品的 |
| 谁。 | 取舍。 | |
| 舆情健康度 | 外部评价、负面信息、风险提示对 | 处理真实问题,补充官方澄清和可 |
| 推荐的影响。 | 信第三方证据。 |
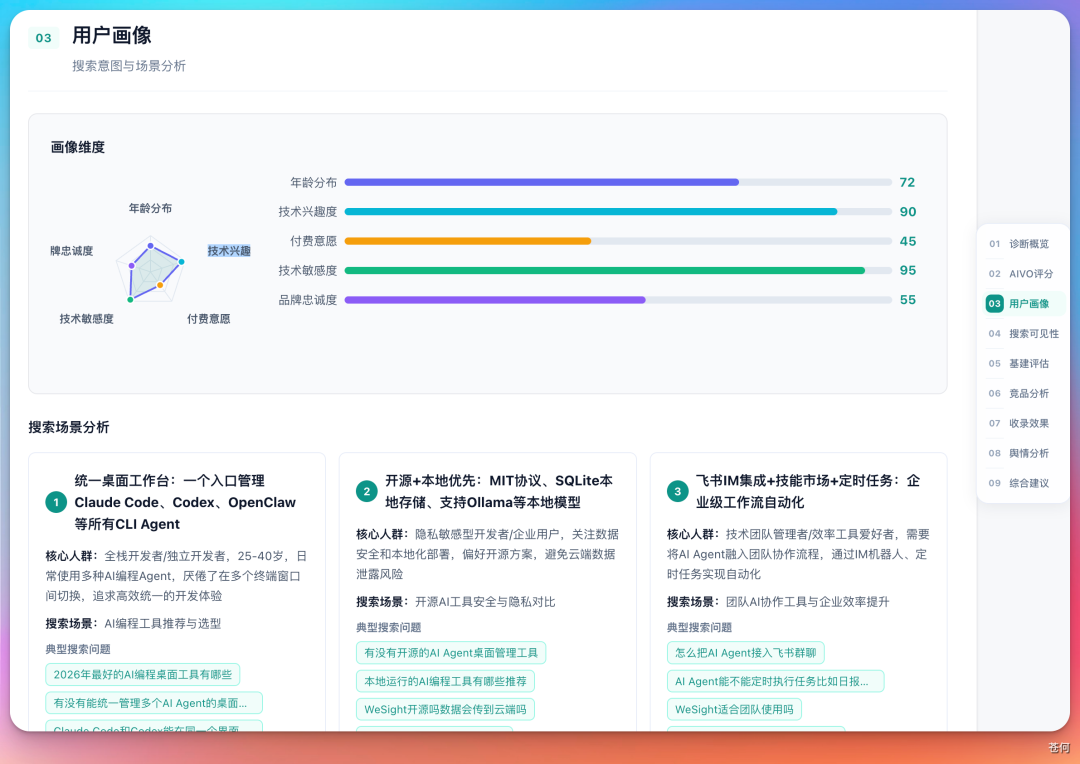
报告模块三:用户画像与意图漏斗偏移
很多品牌做内容时只写自己想表达的卖点,但 GEO 更关心用户真实怎么问。公众号案例中,专家发现用户在大模型里更容易提出“有没有能统一管理多个 AI Agent 的桌面软件”这类问题。这意味着用户关心的是场景和
任务,而不一定知道你的品牌名。
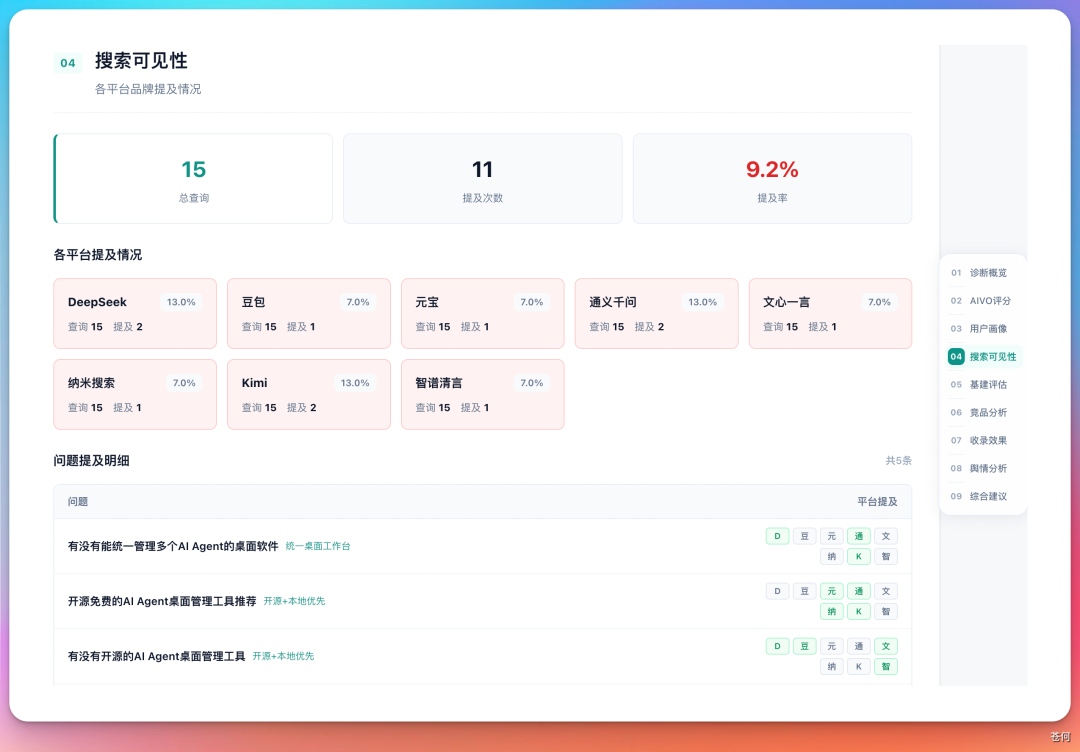
报告模块四:搜索可见性,提及率就是新的排名
在传统搜索里,用户至少还会看到一页链接;在 AI 搜索里,用户往往只看一段回答。品牌是否被提及、在什么位置被提及、是否被作为推荐项出现,就成了新的“搜索排名”。
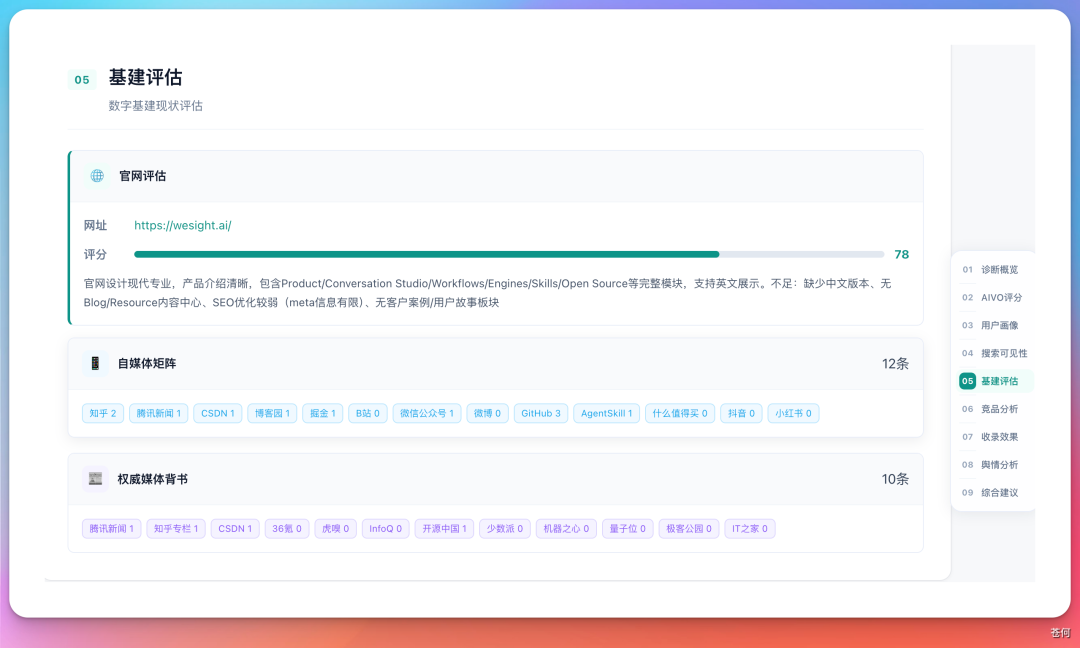
报告模块五:数字基建,先让 AI 有可信资料可读
GEO 不是只靠“发声量”。生成式 AI 需要可引用、可验证、相互印证的可信来源。把基建评估拆成三类:官网评估、自媒体矩阵、权威媒体背书。
全站分卷索引 · 80 卷
- 1第 1 卷
- 2第 2 卷
- 3第 3 卷
- 4第 4 卷
- 5第 5 卷
- 6第 6 卷
- 7第 7 卷
- 8第 8 卷
- 9第 9 卷
- 10第 10 卷
- 11第 11 卷
- 12第 12 卷
- 13第 13 卷
- 14第 14 卷
- 15第 15 卷
- 16第 16 卷
- 17第 17 卷
- 18第 18 卷
- 19第 19 卷
- 20第 20 卷
- 21第 21 卷
- 22第 22 卷
- 23第 23 卷
- 24第 24 卷
- 25第 25 卷
- 26第 26 卷
- 27第 27 卷
- 28第 28 卷
- 29第 29 卷
- 30第 30 卷
- 31第 31 卷
- 32第 32 卷
- 33第 33 卷
- 34第 34 卷
- 35第 35 卷
- 36第 36 卷
- 37第 37 卷
- 38第 38 卷
- 39第 39 卷
- 40第 40 卷
- 41第 41 卷
- 42第 42 卷
- 43第 43 卷
- 44第 44 卷
- 45第 45 卷
- 46第 46 卷
- 47第 47 卷
- 48第 48 卷
- 49第 49 卷
- 50第 50 卷
- 51第 51 卷
- 52第 52 卷
- 53第 53 卷
- 54第 54 卷
- 55第 55 卷
- 56第 56 卷
- 57第 57 卷
- 58第 58 卷
- 59第 59 卷
- 60第 60 卷
- 61第 61 卷
- 62第 62 卷
- 63第 63 卷
- 64第 64 卷
- 65第 65 卷
- 66第 66 卷
- 67第 67 卷
- 68第 68 卷
- 69第 69 卷
- 70第 70 卷
- 71第 71 卷
- 72第 72 卷
- 73第 73 卷
- 74第 74 卷
- 75第 75 卷
- 76第 76 卷
- 77第 77 卷
- 78第 78 卷
- 79第 79 卷
- 80第 80 卷