第 10 卷
3.数据处理,用 Codex 按你的标准检查、修复
你好,我是快刀青衣,得到联合创始人,也是咱们 AI 学习圈的主理人。
前两讲里,我们已经做过两类工作:一类是整理乱七八糟的文件夹,一
类是把零散资料整理成可以汇报的材料包。这些工作即使做错了,通常
还能改,因为东西都还在本地电脑上,最多是不够好看、不够顺手。
快速查看完整课程介绍
这一讲,我们挑战一个新任务,用 Codex 检查数据。数据要看的不是
好不好看,而是够不够准,毕竟你稍有一个差错,可能就会影响预算、
报表、消耗、流水、ROI、投放成本,甚至影响业务判断。尤其是职场
里常见的表格,不一定很大,却很容易脏:字段叫法不一致,金额单位
不一致,计算口径不清楚,或者隐藏着人眼很难发现的小错误。
这一讲,我们不做那种“AI 自动清洗几百个表格”的炫技演示。要做一
个更实用更安全的流程:先让 Codex 看懂数据,再让它向你确认业务
口径,把你的标准沉淀成质检清单,最后按照这个清单去检查数据,生
成候选修复版。
任务分析
很多人一看到表格,就会直接把文件发给 AI,然后说:“帮我查一查这
里面有什么问题。”这个动作最大的问题是:AI 并不知道对你们公司来
说,什么叫“问题”。
同一个字段,在不同公司可能有不同叫法;同一个渠道,在不同团队可
能有不同归类;同一个 ROI、金额、消耗、状态字段,也可能有自己的
口径和例外条件。AI 可以帮你读表、找异常、跑检查,但“什么叫合格”
必须先由你来确认。
所以这一讲的重点不是让 AI 替你判断一切,而是把你自己的业务经验
变成 AI 可以执行的标准。你先告诉它口径,它再按照口径检查;你先
确认边界,它再生成候选修复版。
走完整个流程之后,大家至少会拿到四样东西:一份质检清单,一份问
题清单,一组候选修复版文件,以及一份检查日志。更重要的是,你会
知道每一个问题来自哪个文件、哪一行、哪段原文,后面要不要修,也
能由你自己判断。
先守住安全边界
这一讲我默认大家已经完成了前两讲的基础操作:知道怎么打开 Codex,
知道怎么选择项目文件夹,知道处理真实文件前要先复制一份测试副本,
也知道项目级的 AGENTS.md 可以用来记录规则。
如果还不熟,就先记住三件事。
第一,只读优先。先让 Codex 读文件、盘点问题,不要一上来就让它
改东西。
第二,只操作测试副本。数据类文件风险更高,课堂演示也好,真实工
作也好,都不要让 AI 直接在原始文件上操作。
第三,不要覆盖源文件。无论后面生成检查清单、问题清单,还是候选
修复版,都要另存成新文件。这样哪怕 AI 判断错了,也不会把你原来
的数据弄丢。
这几条规则执行起来,尤其是第一次跑流程的时候可能会慢一点,但这
很重要。等你熟练以后,很多步骤可以加快,但一开始一定要把边界守
住。
准备数据文件和项目入口
这一讲的测试文件夹里准备了一组运营数据。里面有投放计划,包含活
动 ID、预算、追加总预算、CPA、负责人等字段;也有效果日报,记
录每天的消耗、点击数、转化数;还有渠道映射和一份残缺的口径说明。
测试数据文件:
https://drive.weixin.qq.com/s?k=ADQABgdrAAkkVXscQ2
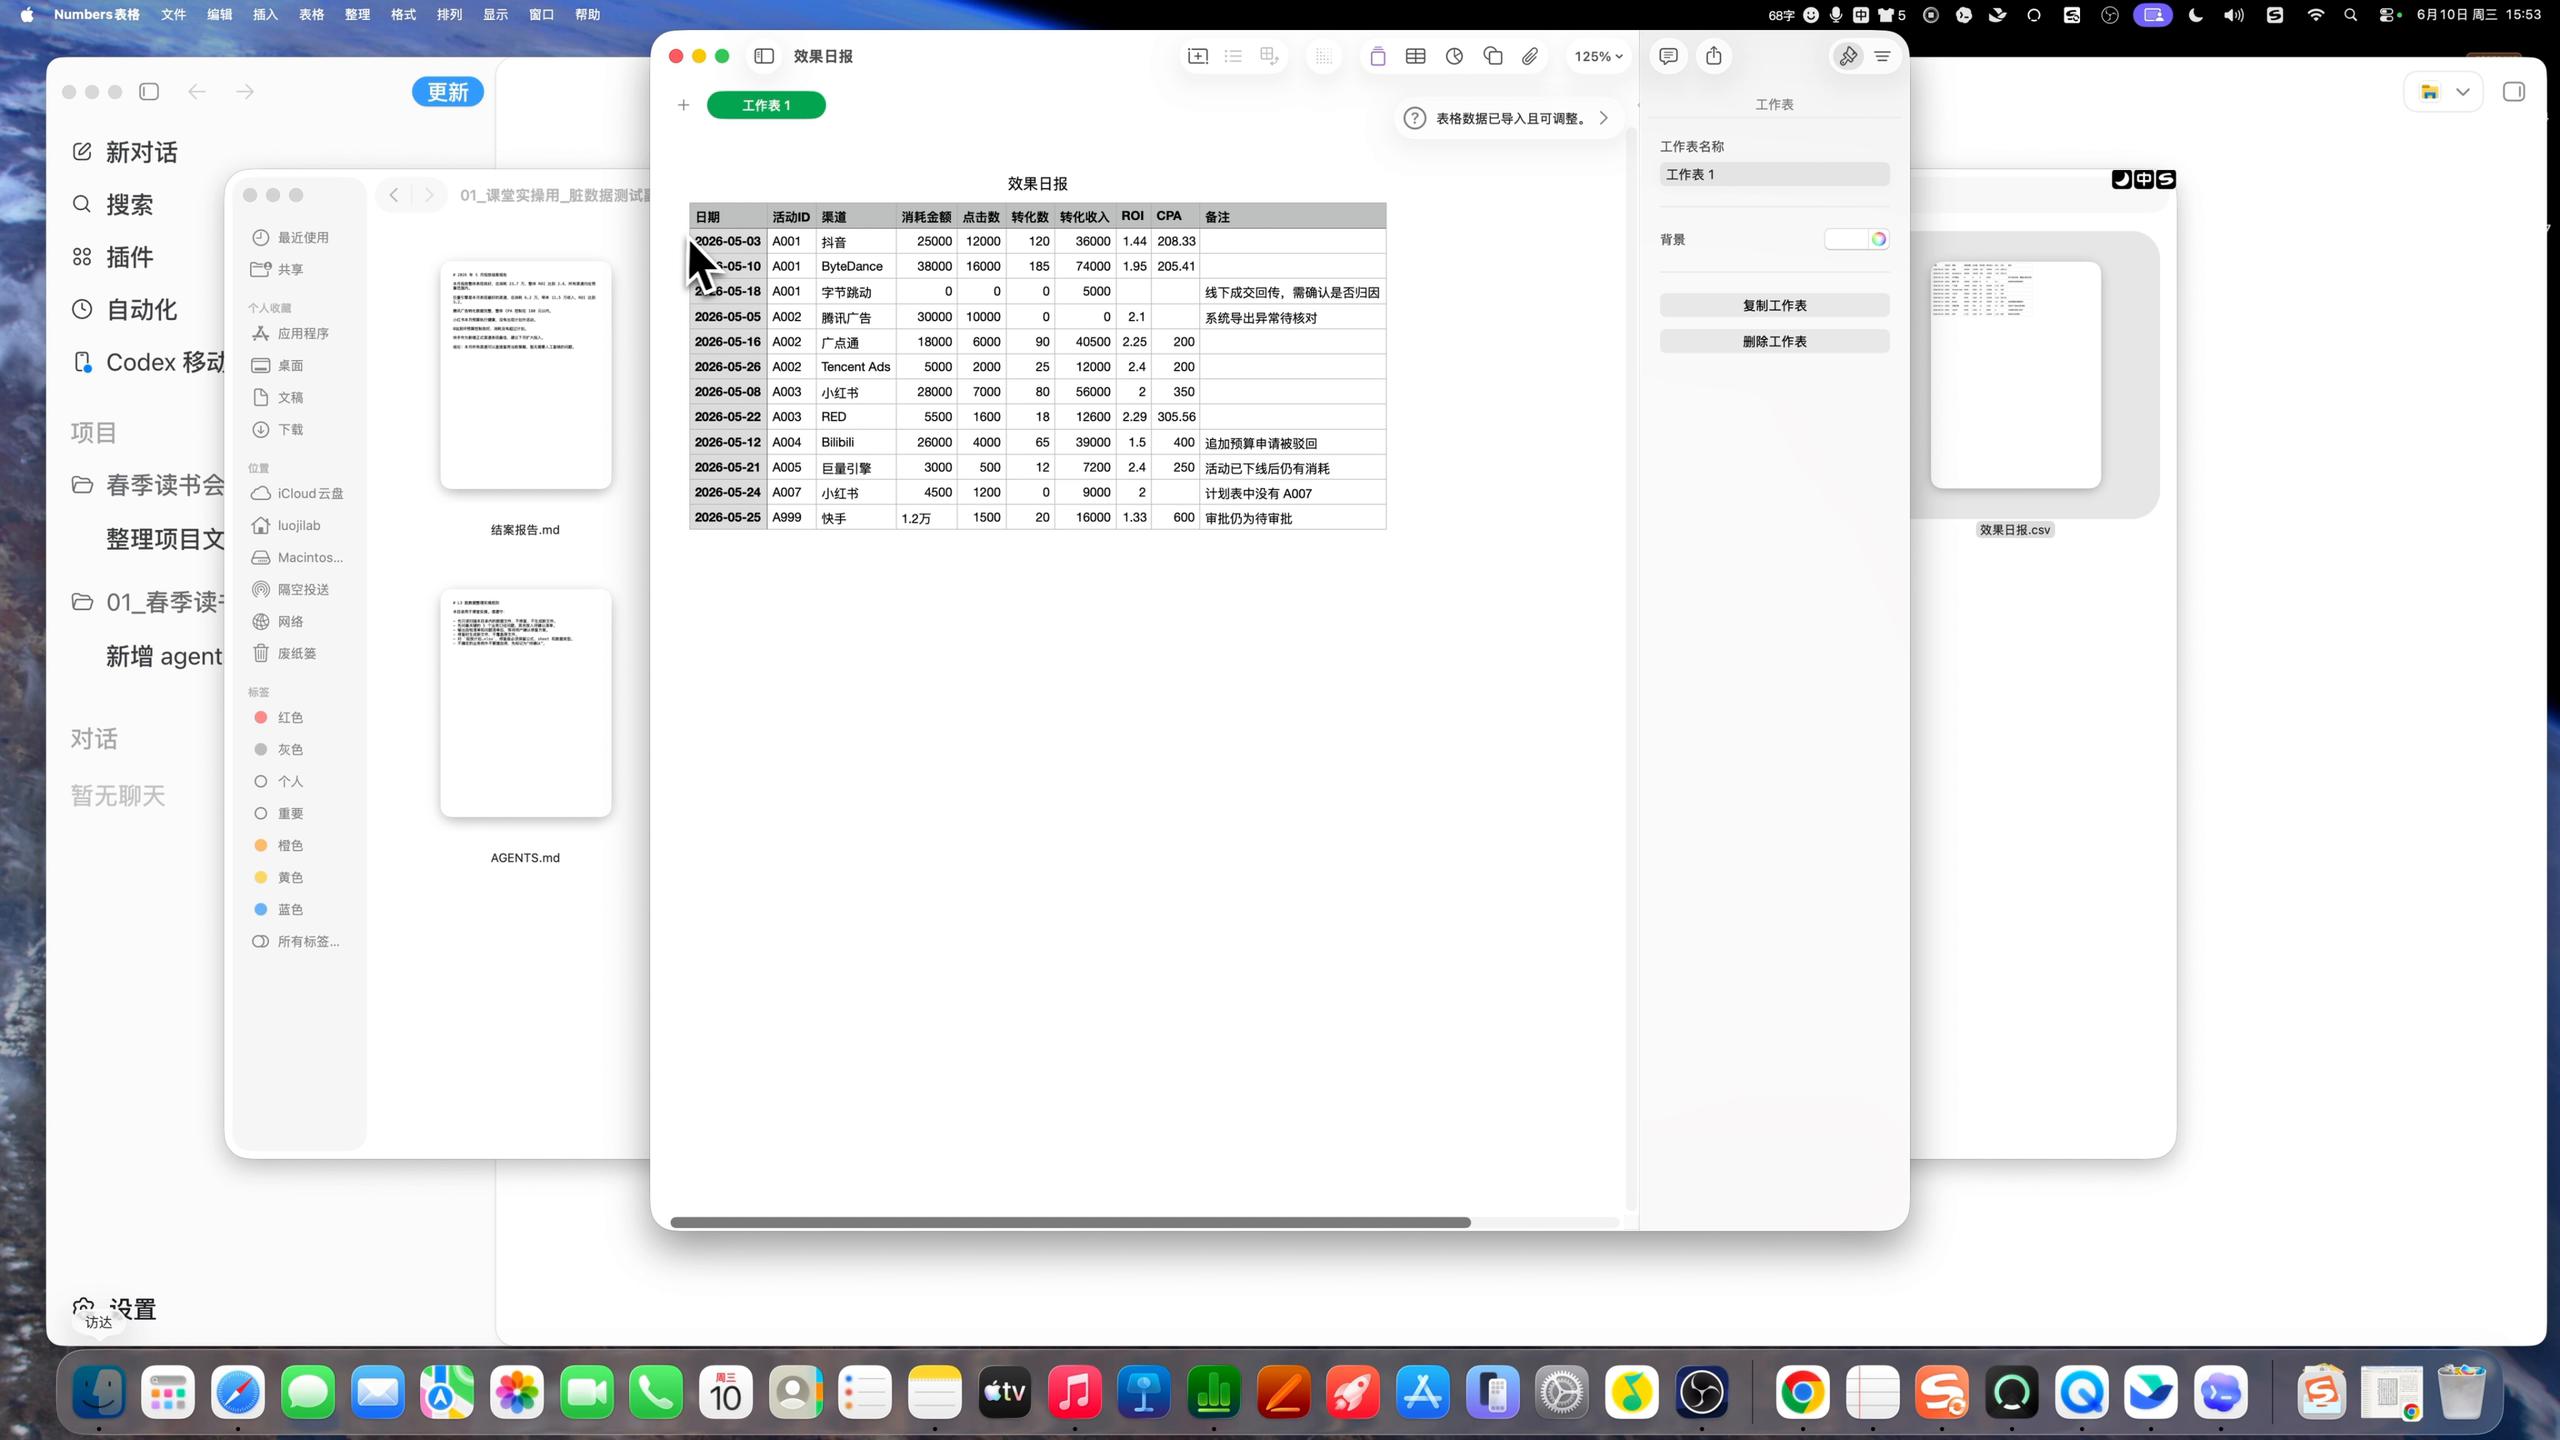
真实工作里也经常是这种状态:不是一个完美数据仓库,而是几个 Excel、
CSV、Markdown 说明混在一起。有日报、周报、月报,有不同渠道