第 12 卷
第一,公司报表里相关渠道统一叫“巨量引擎”,其他渠道也按照映射
表进行统一。
第二,允许把快手列入正式投放渠道。
第三,状态字段统一为“待上线、已上线、暂停、已下线”。
第四,某些超过周期或金额异常的情况不允许例外。
第五,缺失但可以后补的信息,允许标记成“待补充”。
课堂演示为了节奏,只回答了 5 个问题。真实工作里,如果 Codex 找
到了更多口径问题,你可以让它继续问,也可以把所有待确认问题逐条
回答清楚。口径确认得越清楚,后面的质检清单就越像你的工作标准,
而不是 AI 自己的猜测。
第三步:生成自检清单
口径确认完之后,再让 Codex 生成质检清单。这个清单的作用是把刚
才的人类判断变成后面可以反复执行的检查标准。
提示词可以这样写:
请把我们刚才确认的口径整理成自检清单.md。每个检查项都要包括:
- 检查内容。2. 合格标准。3. 严重程度:必须通过 / 建议通过 / 可
选。 4. 需要人工确认的例外情况。只生成清单,不检查、不修复文
件。
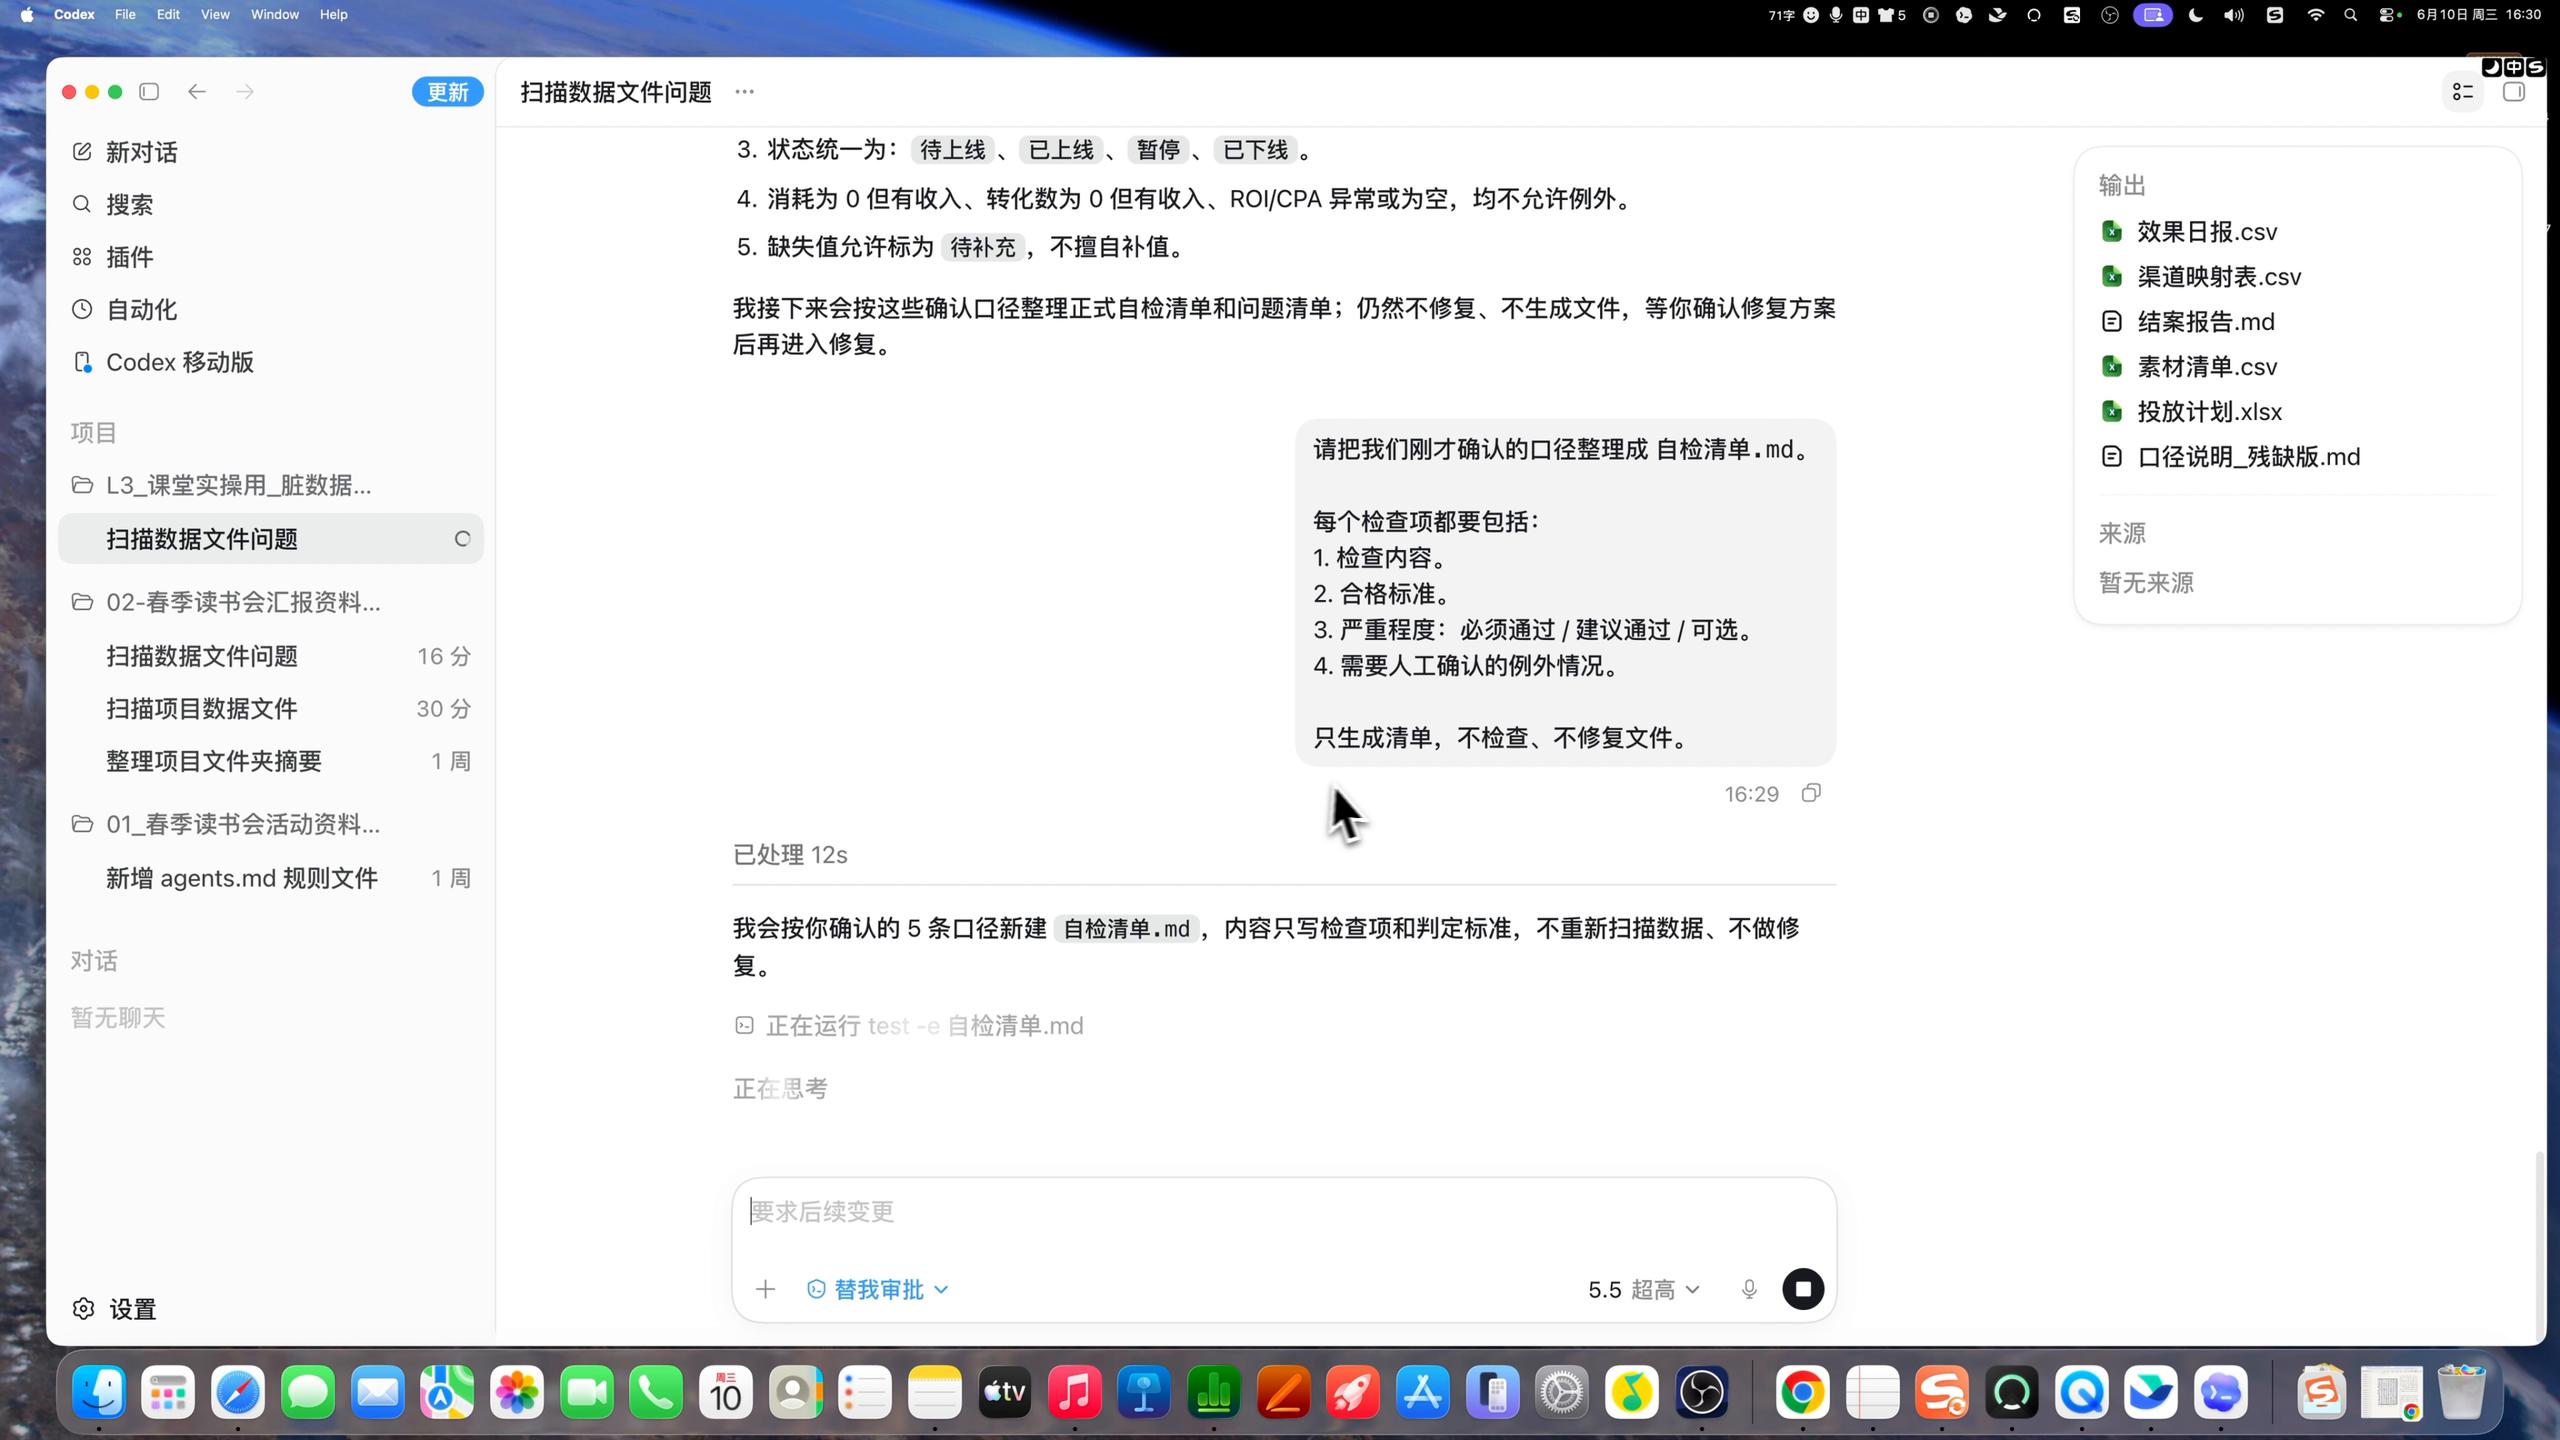
这里要注意,质检清单不是问题清单。质检清单回答的是“以后每次检
查都要检查什么”。比如检查文件范围、检查数据周期、检查渠道统一
叫法、检查快手渠道归类、检查状态字段枚举、检查金额单位等。
这一步生成的文件,也应该只是新文件。它可以出现在 Codex 右侧输
出里,点开就能看。它的价值是:你不需要每次都重新解释业务标准,
标准可以被写下来,未来也可以继续复用。
第四步:按清单输出问题清单
有了质检清单之后,才进入真正的数据检查。这里仍然不是直接修复,
而是按照清单逐项检查所有数据文件,输出问题清单。
提示词可以这样写:
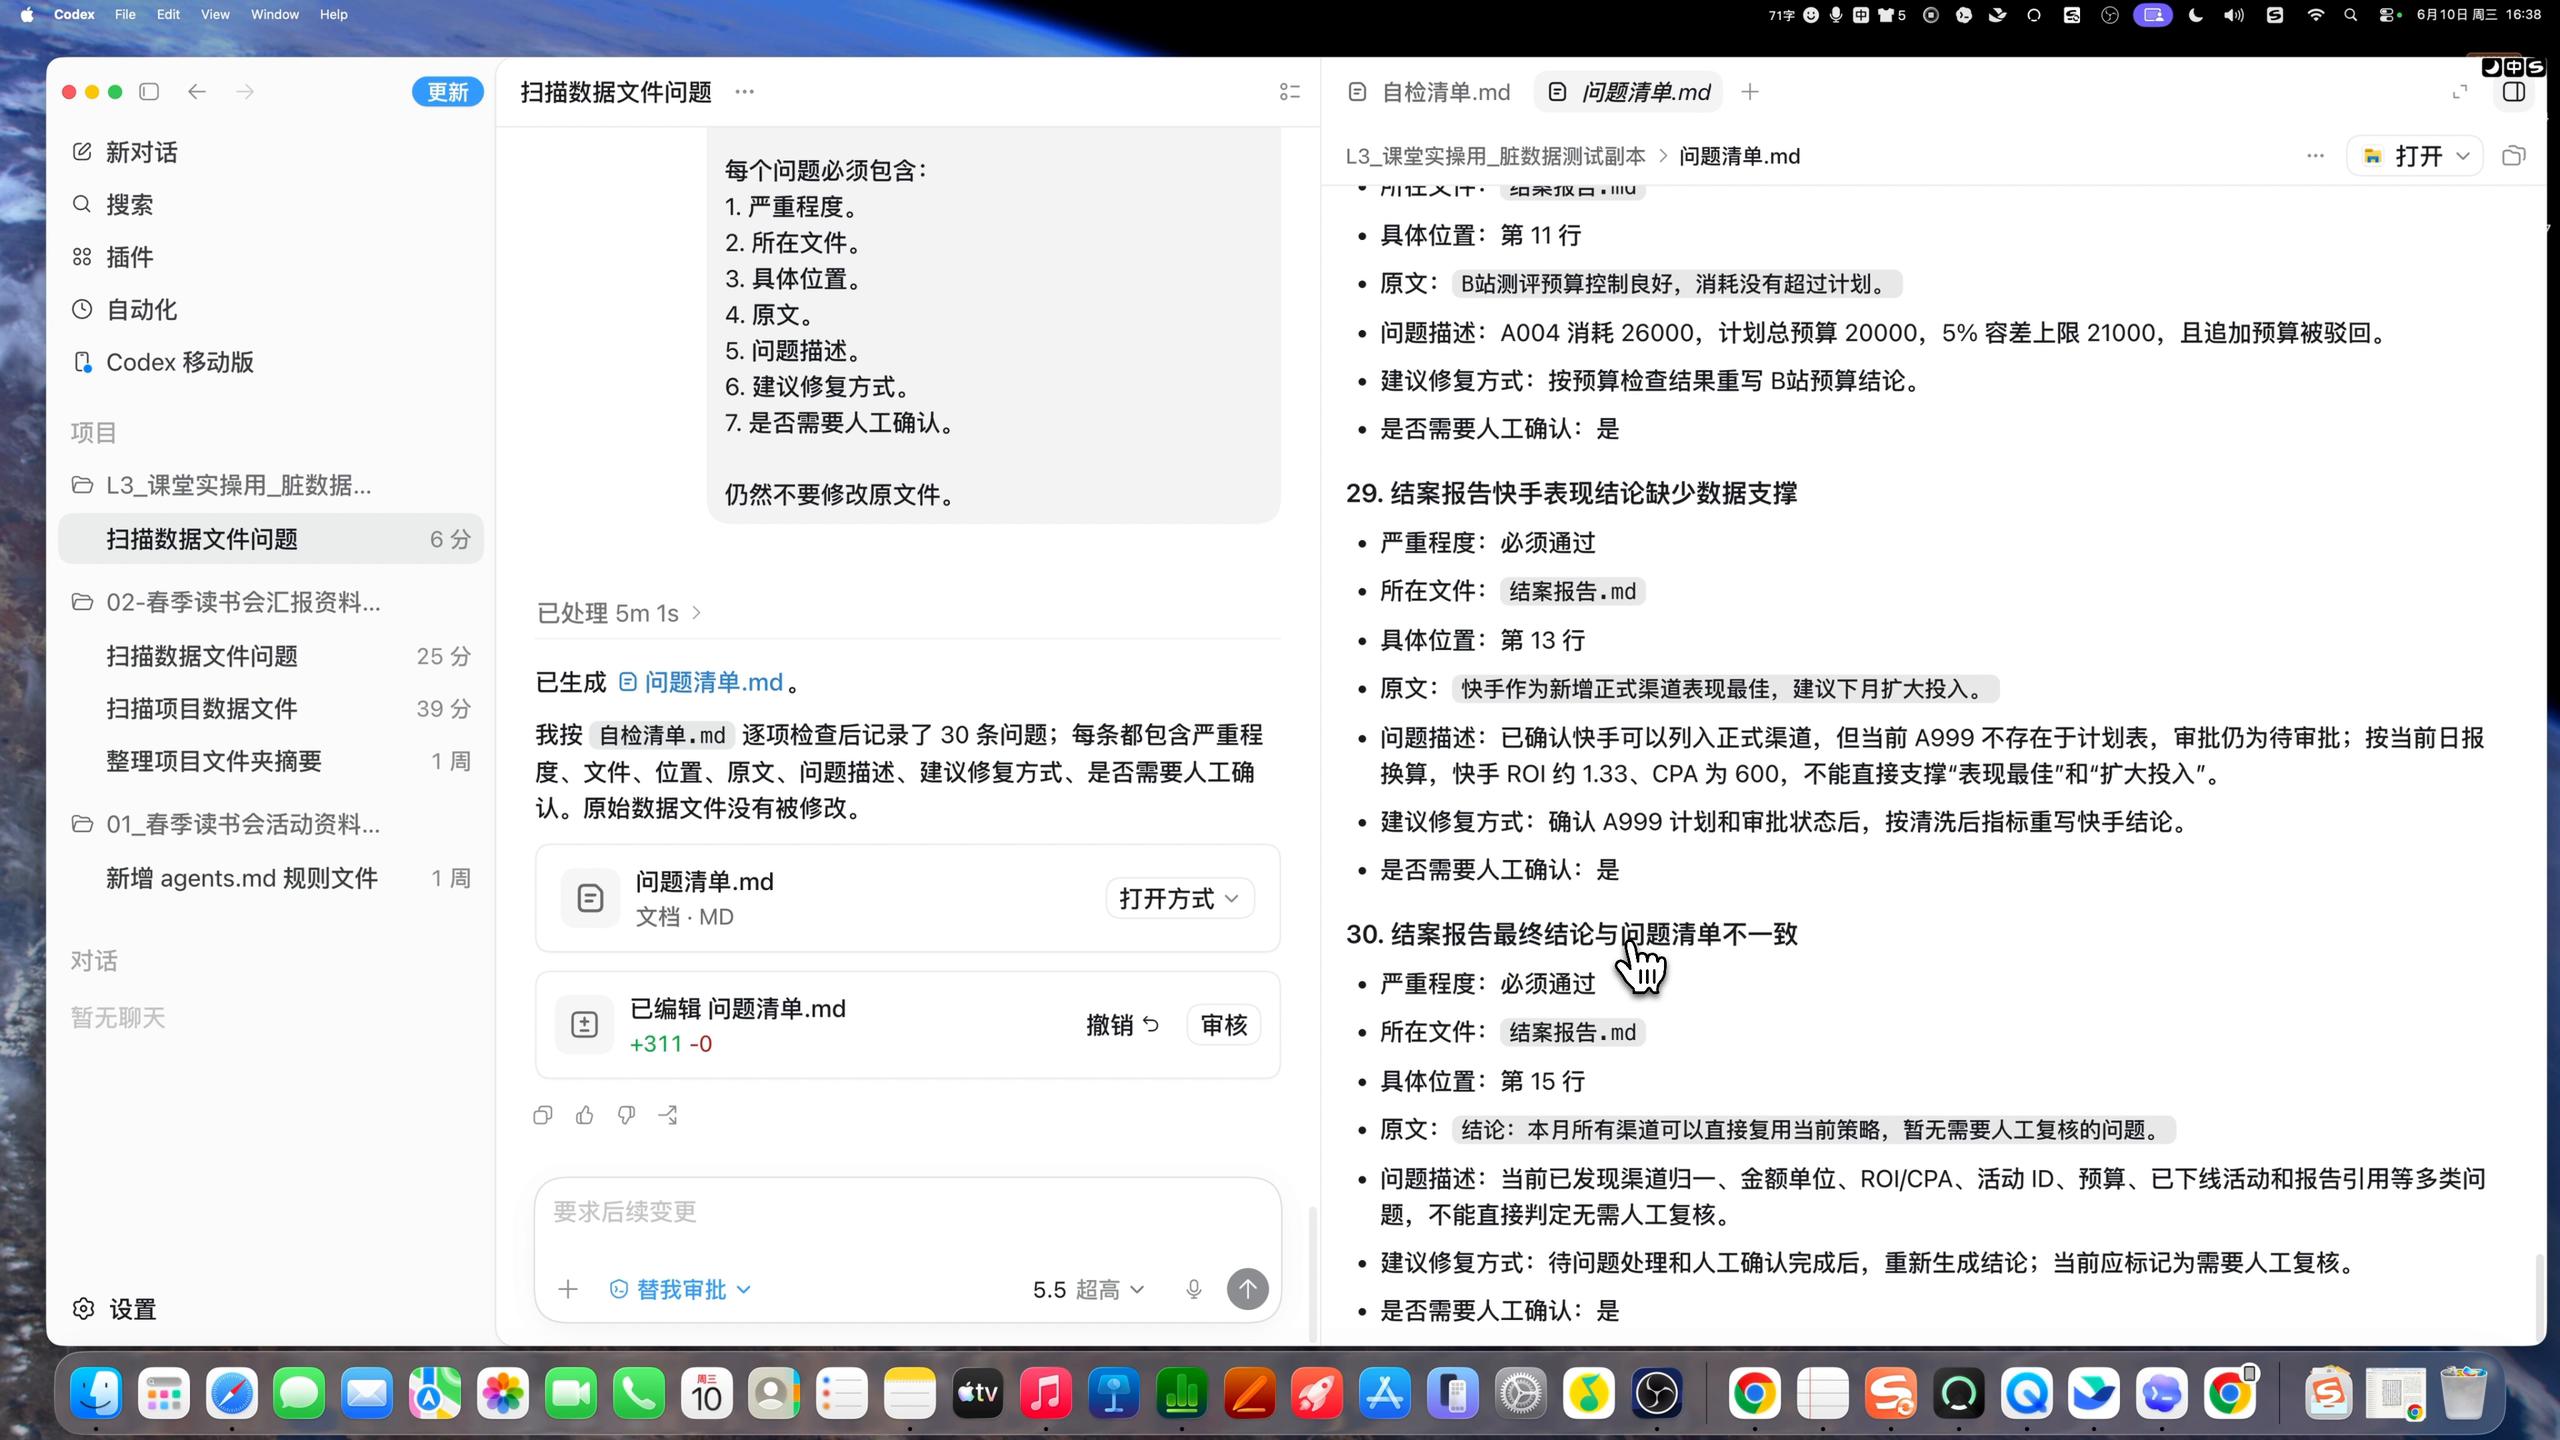
请按自检清单.md 逐项检查所有数据文件,输出问题清单.md。每个
问题必须包含: 1. 严重程度。 2. 所在文件。 3. 具体位置。 4. 原
文。 5. 问题描述。 6. 建议修复方式。 7. 是否需要人工确认。仍然
不要修改原文件。
这一步跑完后,Codex 可能会列出很多问题。演示里,它生成了一份
包含 30 个问题的问题清单,比如素材投放日期超出本轮数据周期,渠
道字段叫法不一致,金额单位有的写数字、有的写“2 万”“1.2 万”,
状态字段不在统一枚举里。
问题清单出来以后,大家不要急着全盘接受。因为这是你的工作,Codex
只是帮你把问题列出来。你需要判断哪些是真问题,哪些是 AI 理解错
了,哪些需要修,哪些可以保留。比如 30 个问题里,也许只有 28 个
需要修,另外 2 个是合理例外。这个确认过程不能省。
这一步最重要的能力,是 Codex 可以把问题定位到具体文件、具体行、
具体原文。过去需要人工核对多个表格,很容易漏掉跨文件的小问题;
现在它可以把这些线索集中列出来,交给你判断。
第五步:只生成候选修复版
确认问题清单之后,才让 Codex 生成候选修复版。这里仍然要守住一
个原则:不动源文件,只生成新文件。