第 29 卷
这里我用的是阶跃星辰的语音能力。阶跃星辰是一家做大模型和多模态
能力的公司,开放平台提供语音模型:ASR 用来把视频或音频里的口播
转成文字,TTS 则反过来把文字转成语音。
官网:
www.stepfun.com
开放平台:
platform.stepfun.com
如果你后续想持续做口播类短视频,建议至少准备一个可用的中文 ASR
能力。这样你既可以把人的口播转成字幕,也可以在需要旁白时,把文
字转成 AI 语音。
素材插入,AI 会补上很多你没说清的细节
就在我以为视频基本完成时,又来了一个新需求。
同事说,除了直播长视频,还有一段手机拍摄的素材,以及几张图片,
需要加进这条短视频里。对一个剪辑小白来说,这里马上出现了几个难
点:素材应该截哪一段?插到哪里?插多长?是全屏插入,还是画中
画?图片又应该放在什么位置?
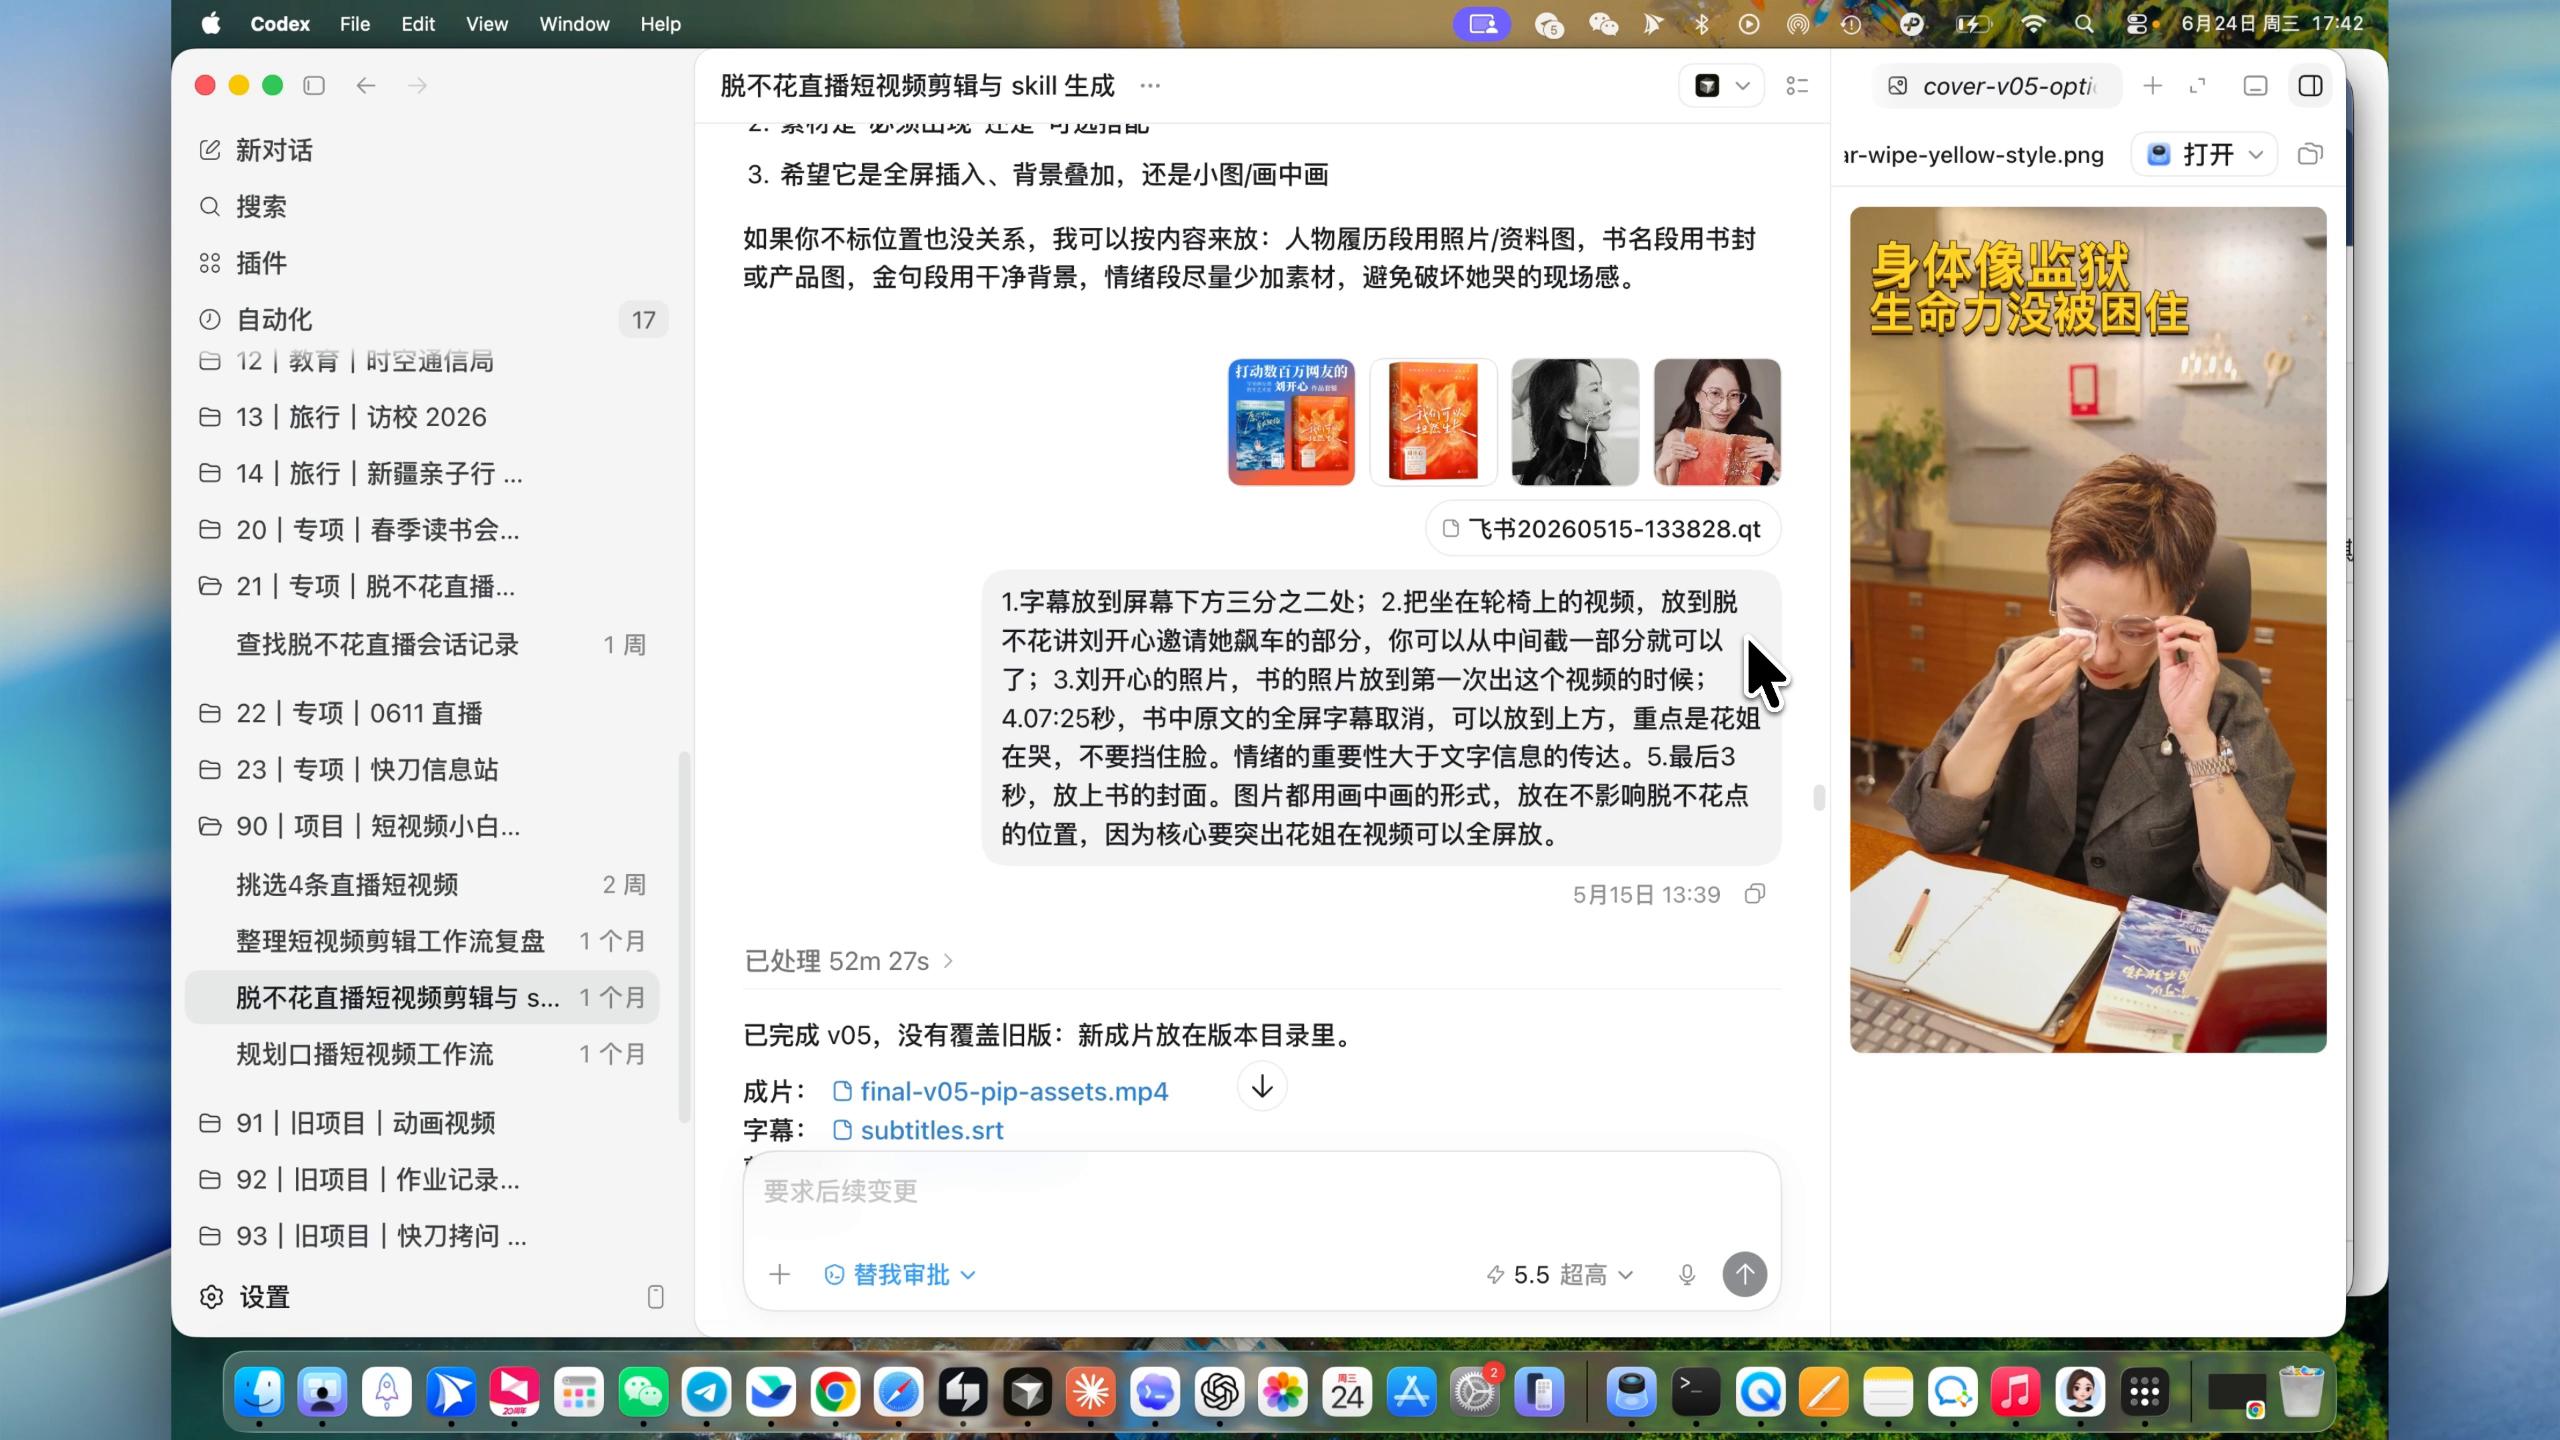
我当时给 AI 的指令其实很粗。我只是说,把坐在轮椅上的视频放在脱
不花讲刘开心邀请她“飙车”的部分,也就是后面讲到她让脱不花兜风
的那段,中间截一段就可以了。注意,我并不知道那个部分在成片里的
准确位置,也没有告诉它应该截哪一段。
我还顺手提了几个很口语化的要求:字幕要往屏幕下方放,书中原文那
段全屏字幕不要挡脸,最后几秒放书的封面。你看,这些要求没有任何
专业剪辑术语,本质上就是把人的观感说清楚。
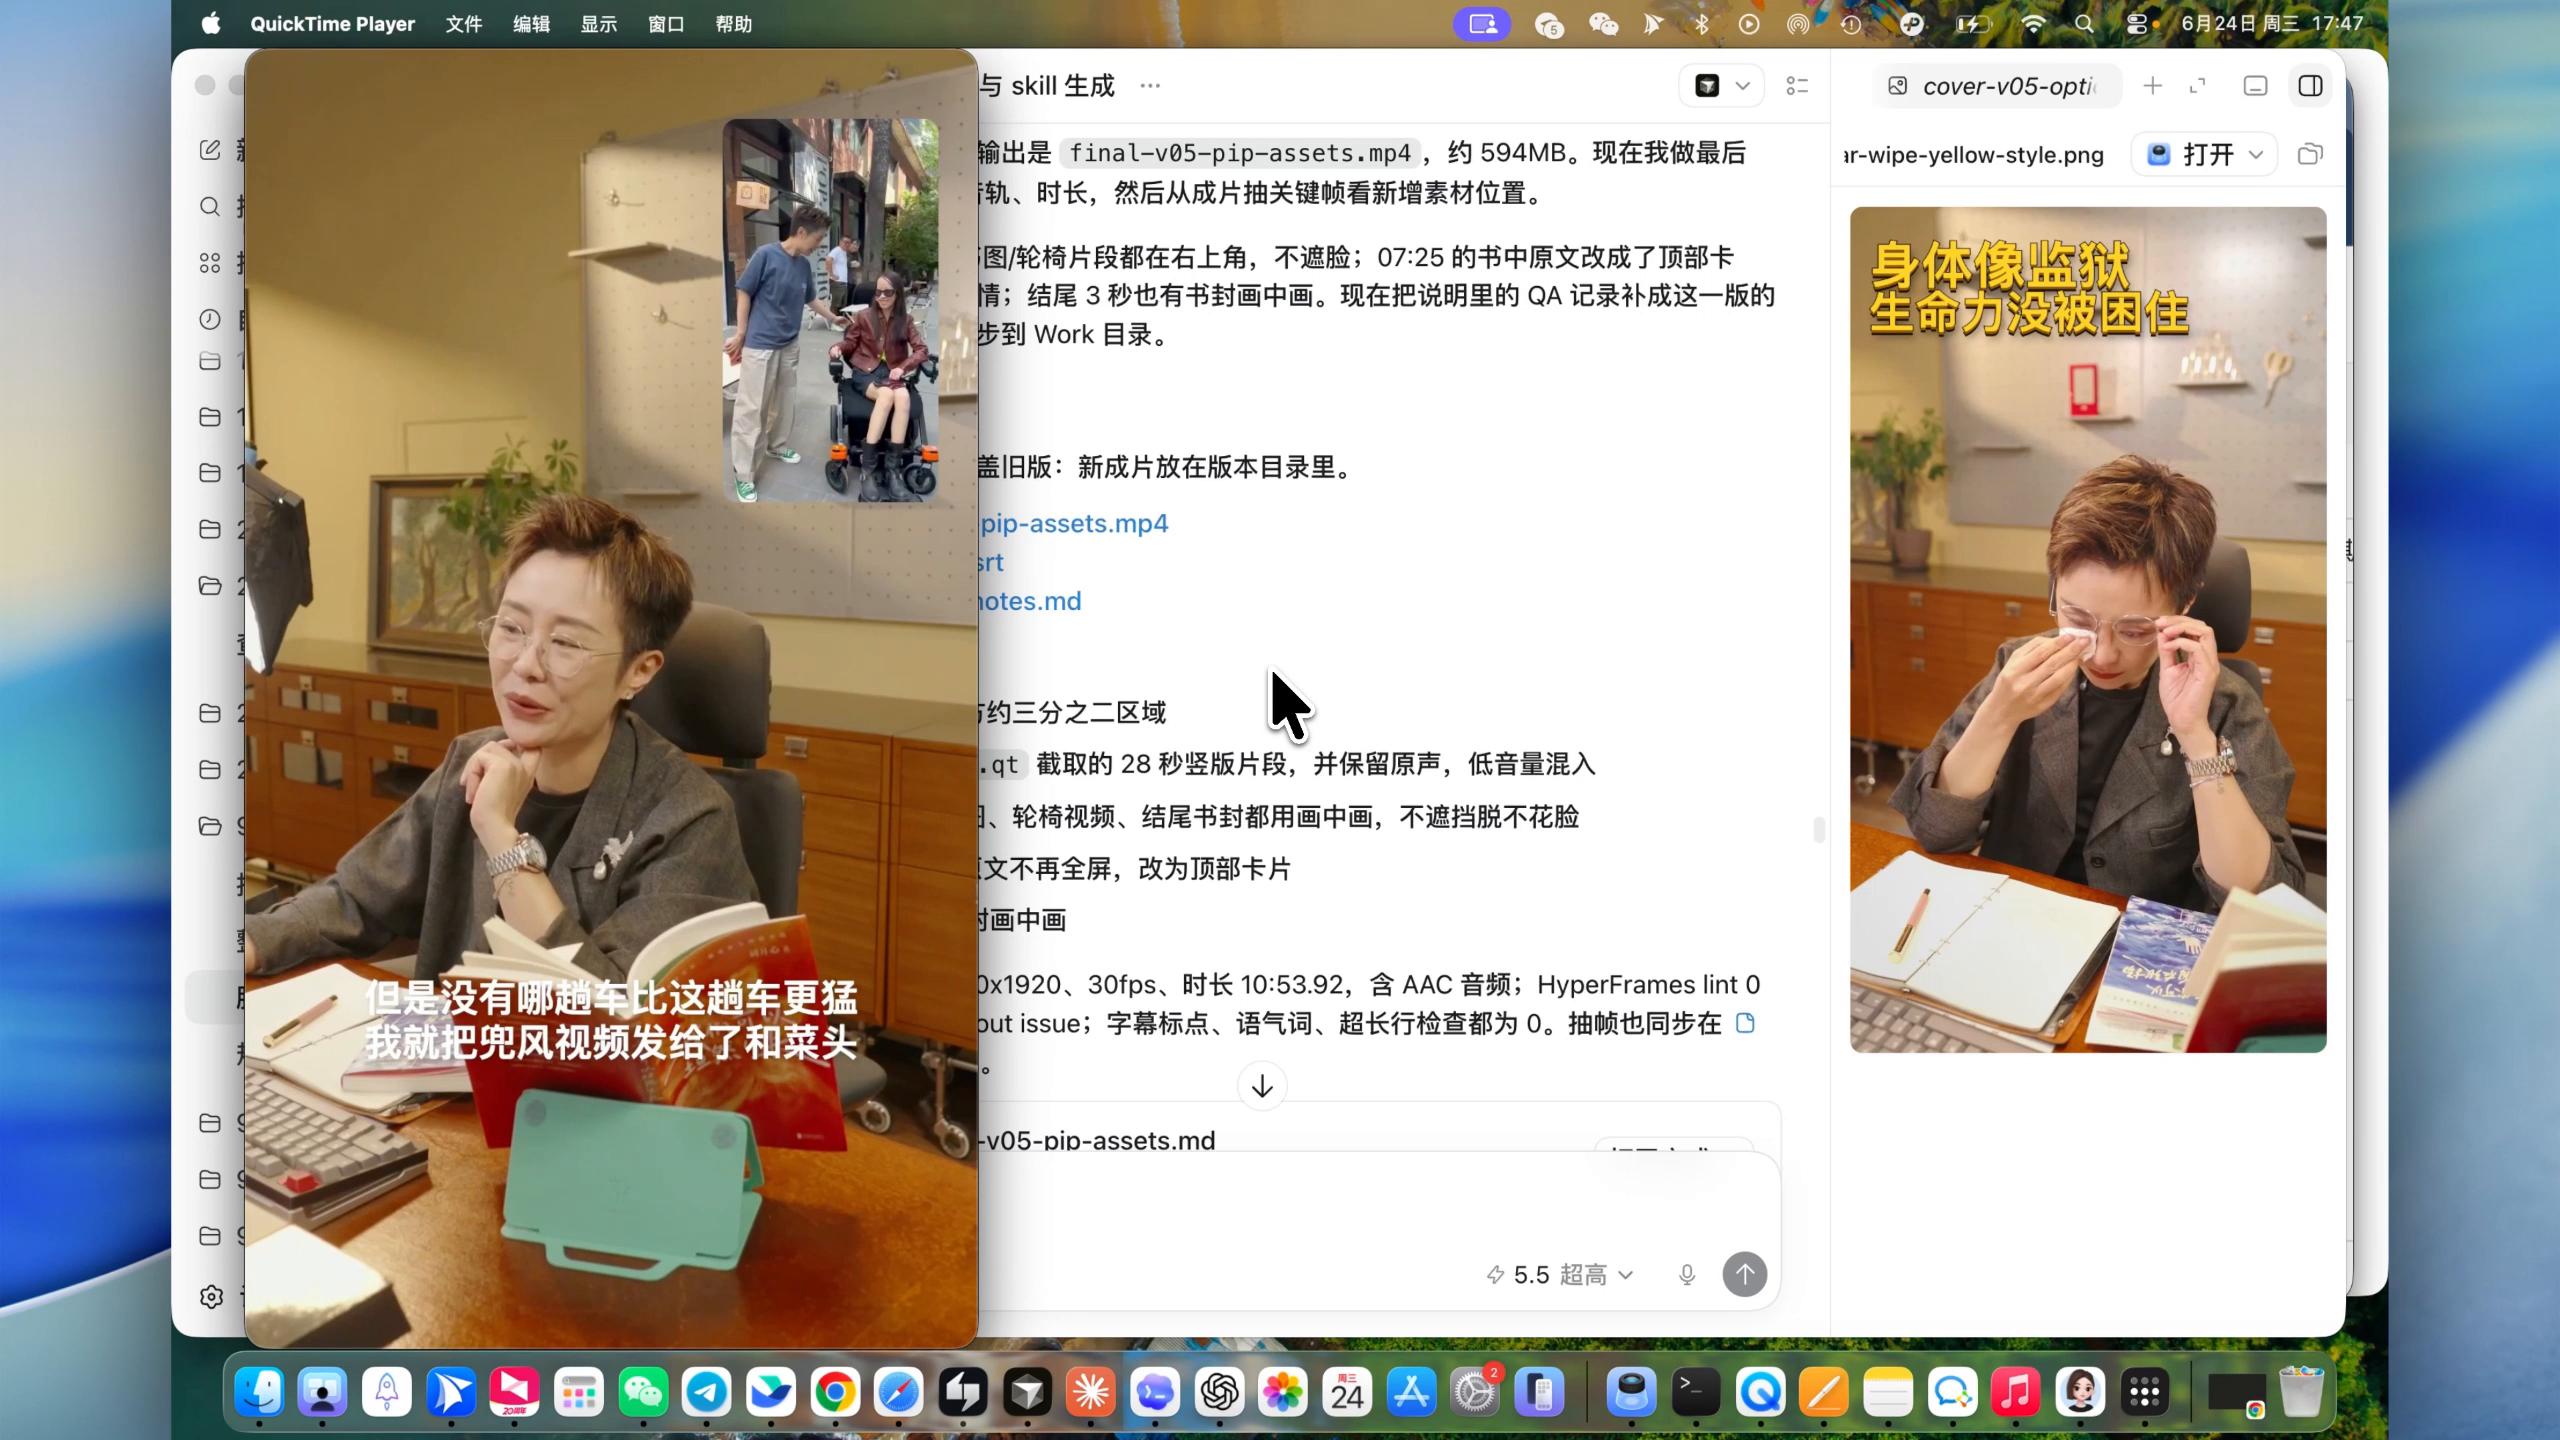
Codex 处理了很久,先识别清楚哪些素材是什么,再按照内容点去放。
它没有完全照我的“全屏插入”执行,而是判断画中画更合适;还保留
了素材里的环境声,同时把声音调低,避免和脱不花的主声打架。最后
它输出的是一个新的 v05 素材版,没有覆盖旧版。
这对我来说是一个很典型的“Aha 时刻”。我只提出一个模糊需求,但
AI 为了最终效果,自己补上了背后的很多剪辑逻辑。
它还会判断图片应该放在哪里。比如讲到刘开心是谁的时候,人物图片
出现;讲到两本书时,两本书的图片出现;讲到她邀请脱不花“飙车”、
一起兜风时,手机拍摄的轮椅素材插入。它不是随机插素材,而是在用
内容理解去匹配画面位置。
把一次剪辑经验沉淀成 Skill
这条短视频做完以后,我又让 Codex 做了一件事:把这次直播剪辑工
作流打包成一个 Skill。