第 11 卷
的投放报表,也有前人留下来的说明文档。问题常常不是单个表格看不
懂,而是跨文件放在一起之后,口径对不上。
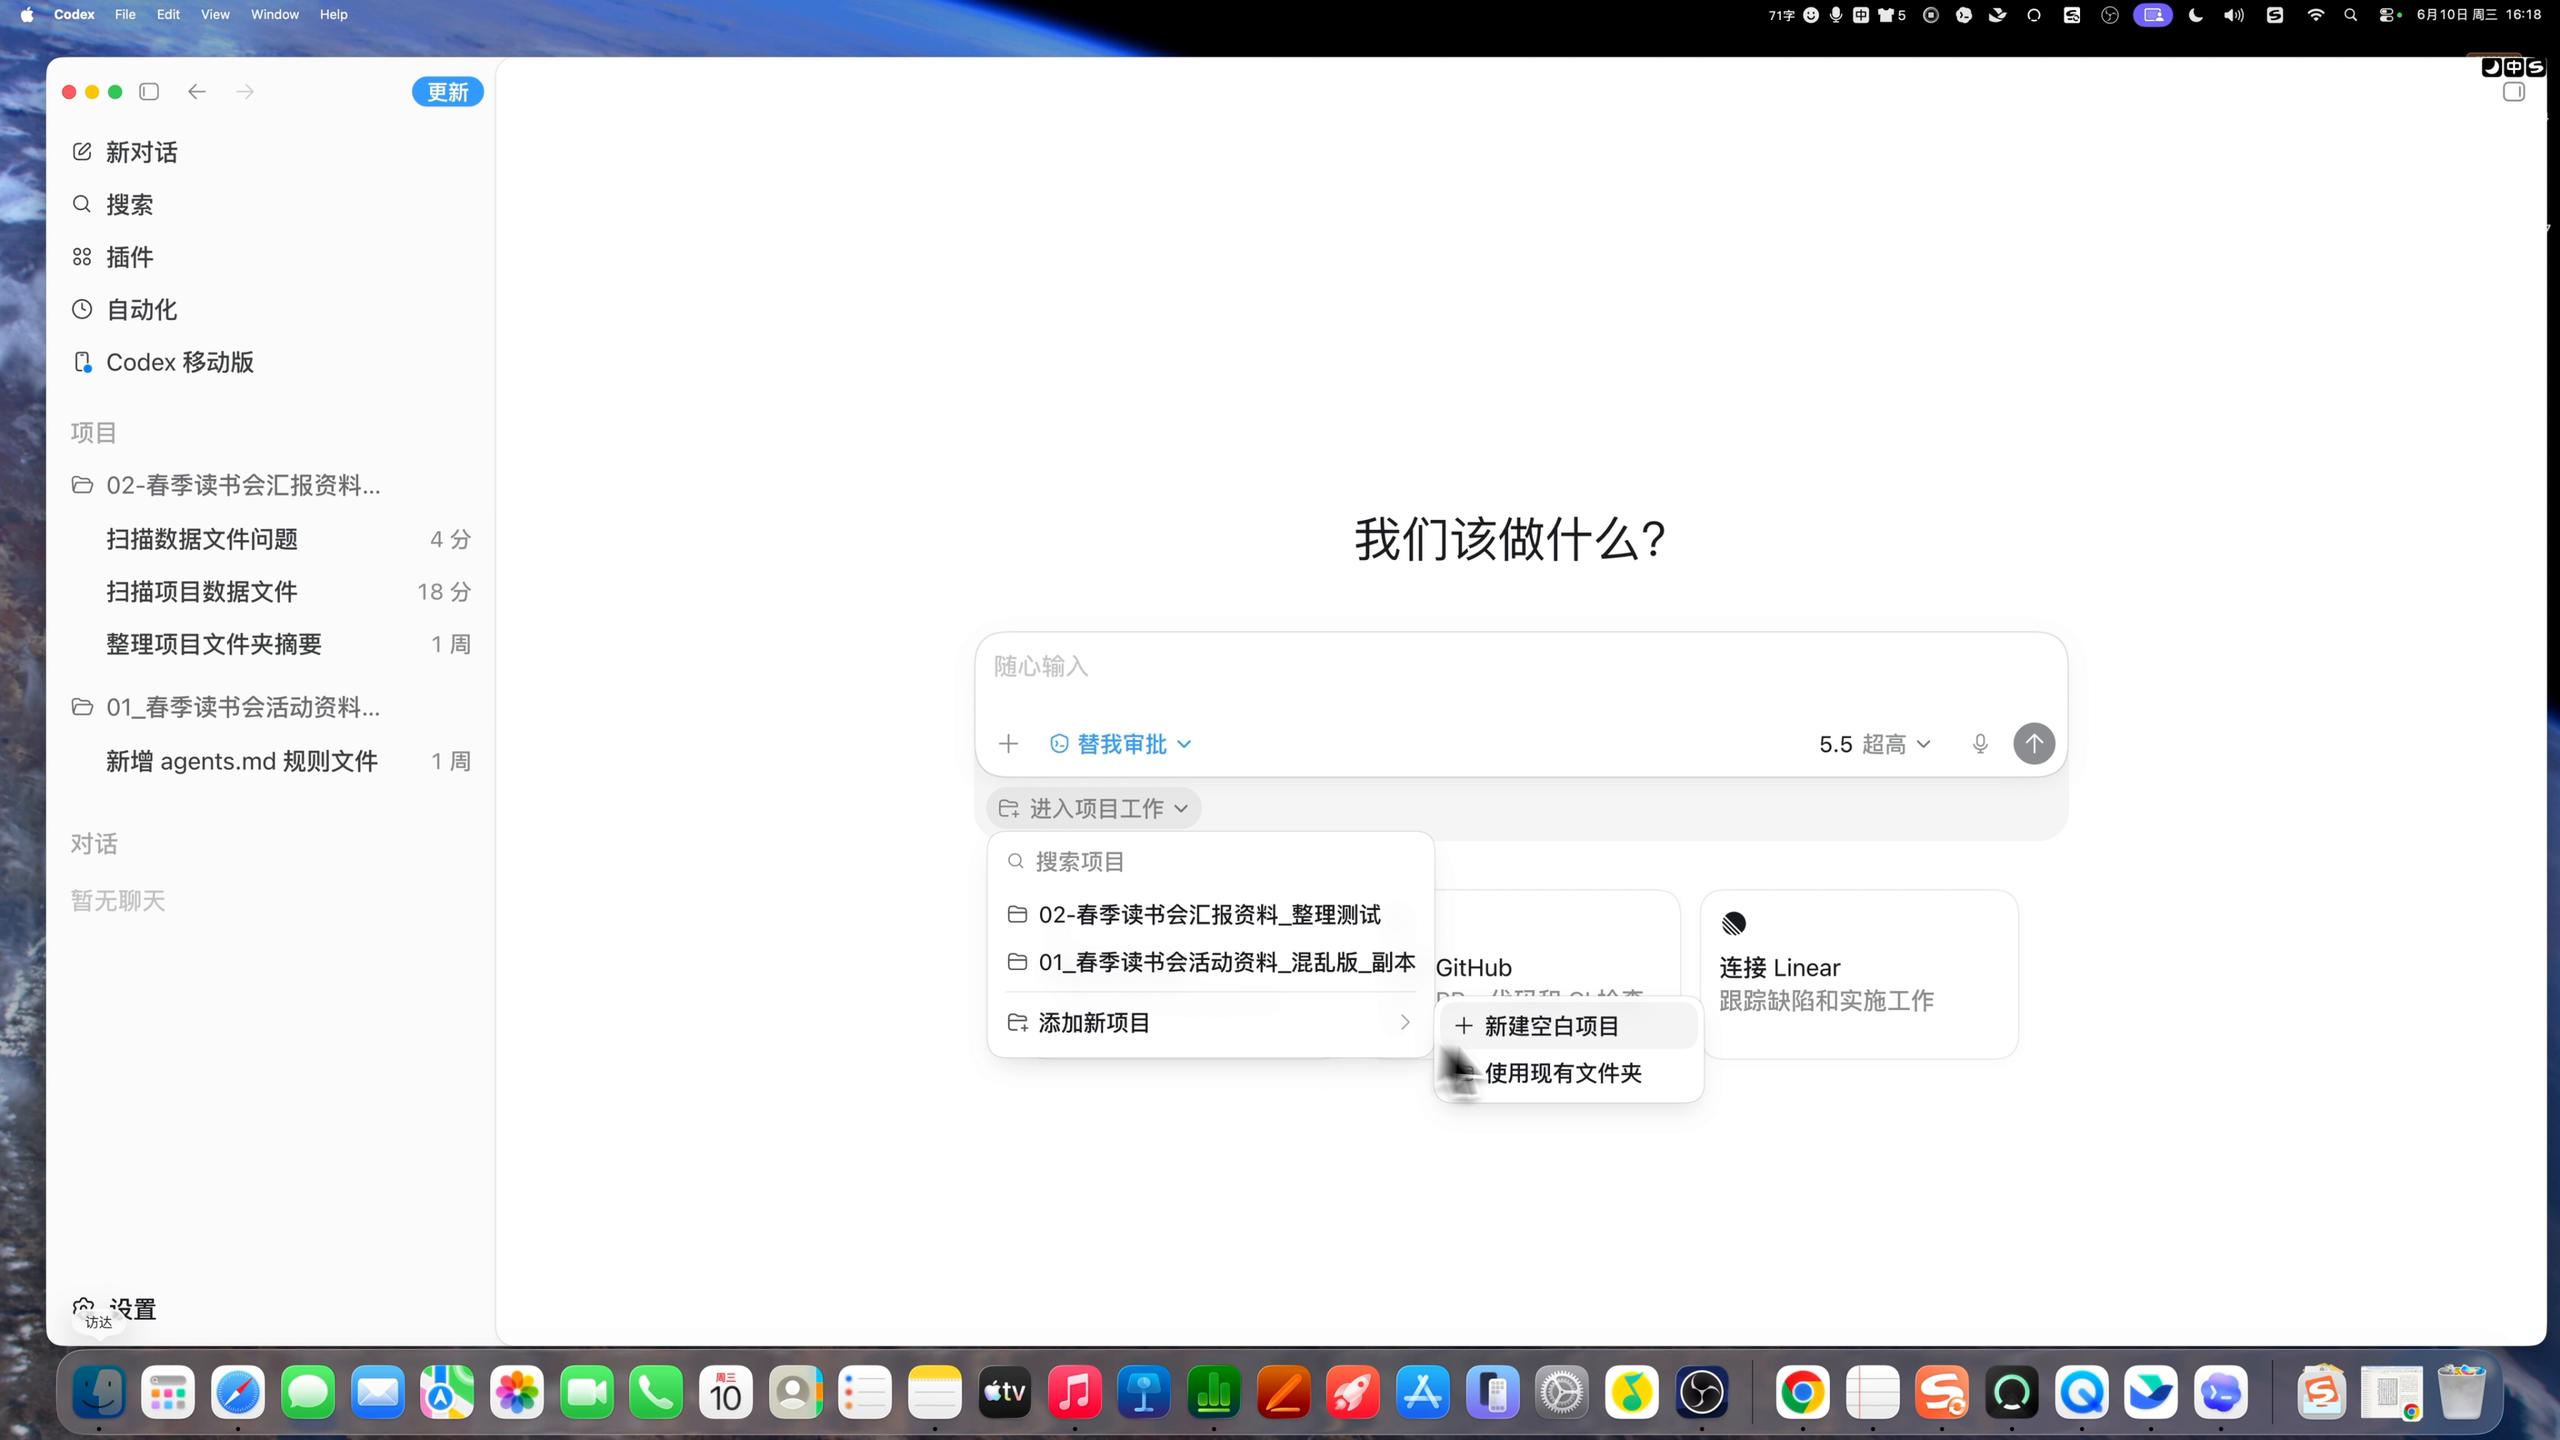
操作前先回到 Codex,进入对应项目。如果当前任务是另一个文件夹,
就新建项目或添加现有文件夹,确认 Codex 进入的是这次要处理的 L3
数据文件夹。这个动作很关键,因为项目选错了,它读到的就会是别的
文件。
如果文件夹层级比较深,或者只想处理其中一个子文件夹,也可以在提
示词里明确说明范围。目标是让 Codex 先知道:这次只处理哪些数据
文件,哪些隐藏目录、依赖文件、已生成产物不要碰。
第一步:只读扫描,先让 Codex 看懂数据
第一步不要让 Codex 修复数据,而是让它只读扫描。提示词可以这样
写:
请先只读扫描当前项目中的数据文件。要求: 1. 不修复、不生成新
文件、不覆盖任何原文件。 2. 忽略隐藏目录、依赖文件和已生成产物。
- 列出你发现的字段不一致、金额单位不一致、计算口径不明、疑似
超预算、报告引用错误等问题。 4. 每个发现都要写清楚文件名、位置
和原文。 5. 扫描完成后,不要直接下结论,先准备向我提问。
这段提示词里有几个关键点。
第一是“不修复、不生成新文件、不覆盖任何源文件”,它保证这一步
只是检查,不会损害原始数据。
第二是“忽略隐藏目录、依赖文件和已生成产物”,它让 Codex 把注
意力放在当前业务文件上,不要被缓存、依赖、历史输出带偏。
第三是“列出常见数据问题”。这里不需要穷举所有可能性,但你可以
把自己工作中最容易踩坑的问题写进去。不同岗位、行业、公司关注点
不一样,你越知道自己怕什么,Codex 越容易按你的真实场景去查。
第四是“每个发现写清楚文件名、位置和原文”。这是为了后面溯源。
数据核查不能只说“这里可能有问题”,必须能回到具体文件、具体行、
具体原文。
第五是“扫描完成后不要直接下最终结论,先准备向我提问”。这句非
常重要。我们不是把文件夹扔给 AI,让它自己决定一切,而是先让它熟
悉工作,再把最关键的口径问题拿回来问你。
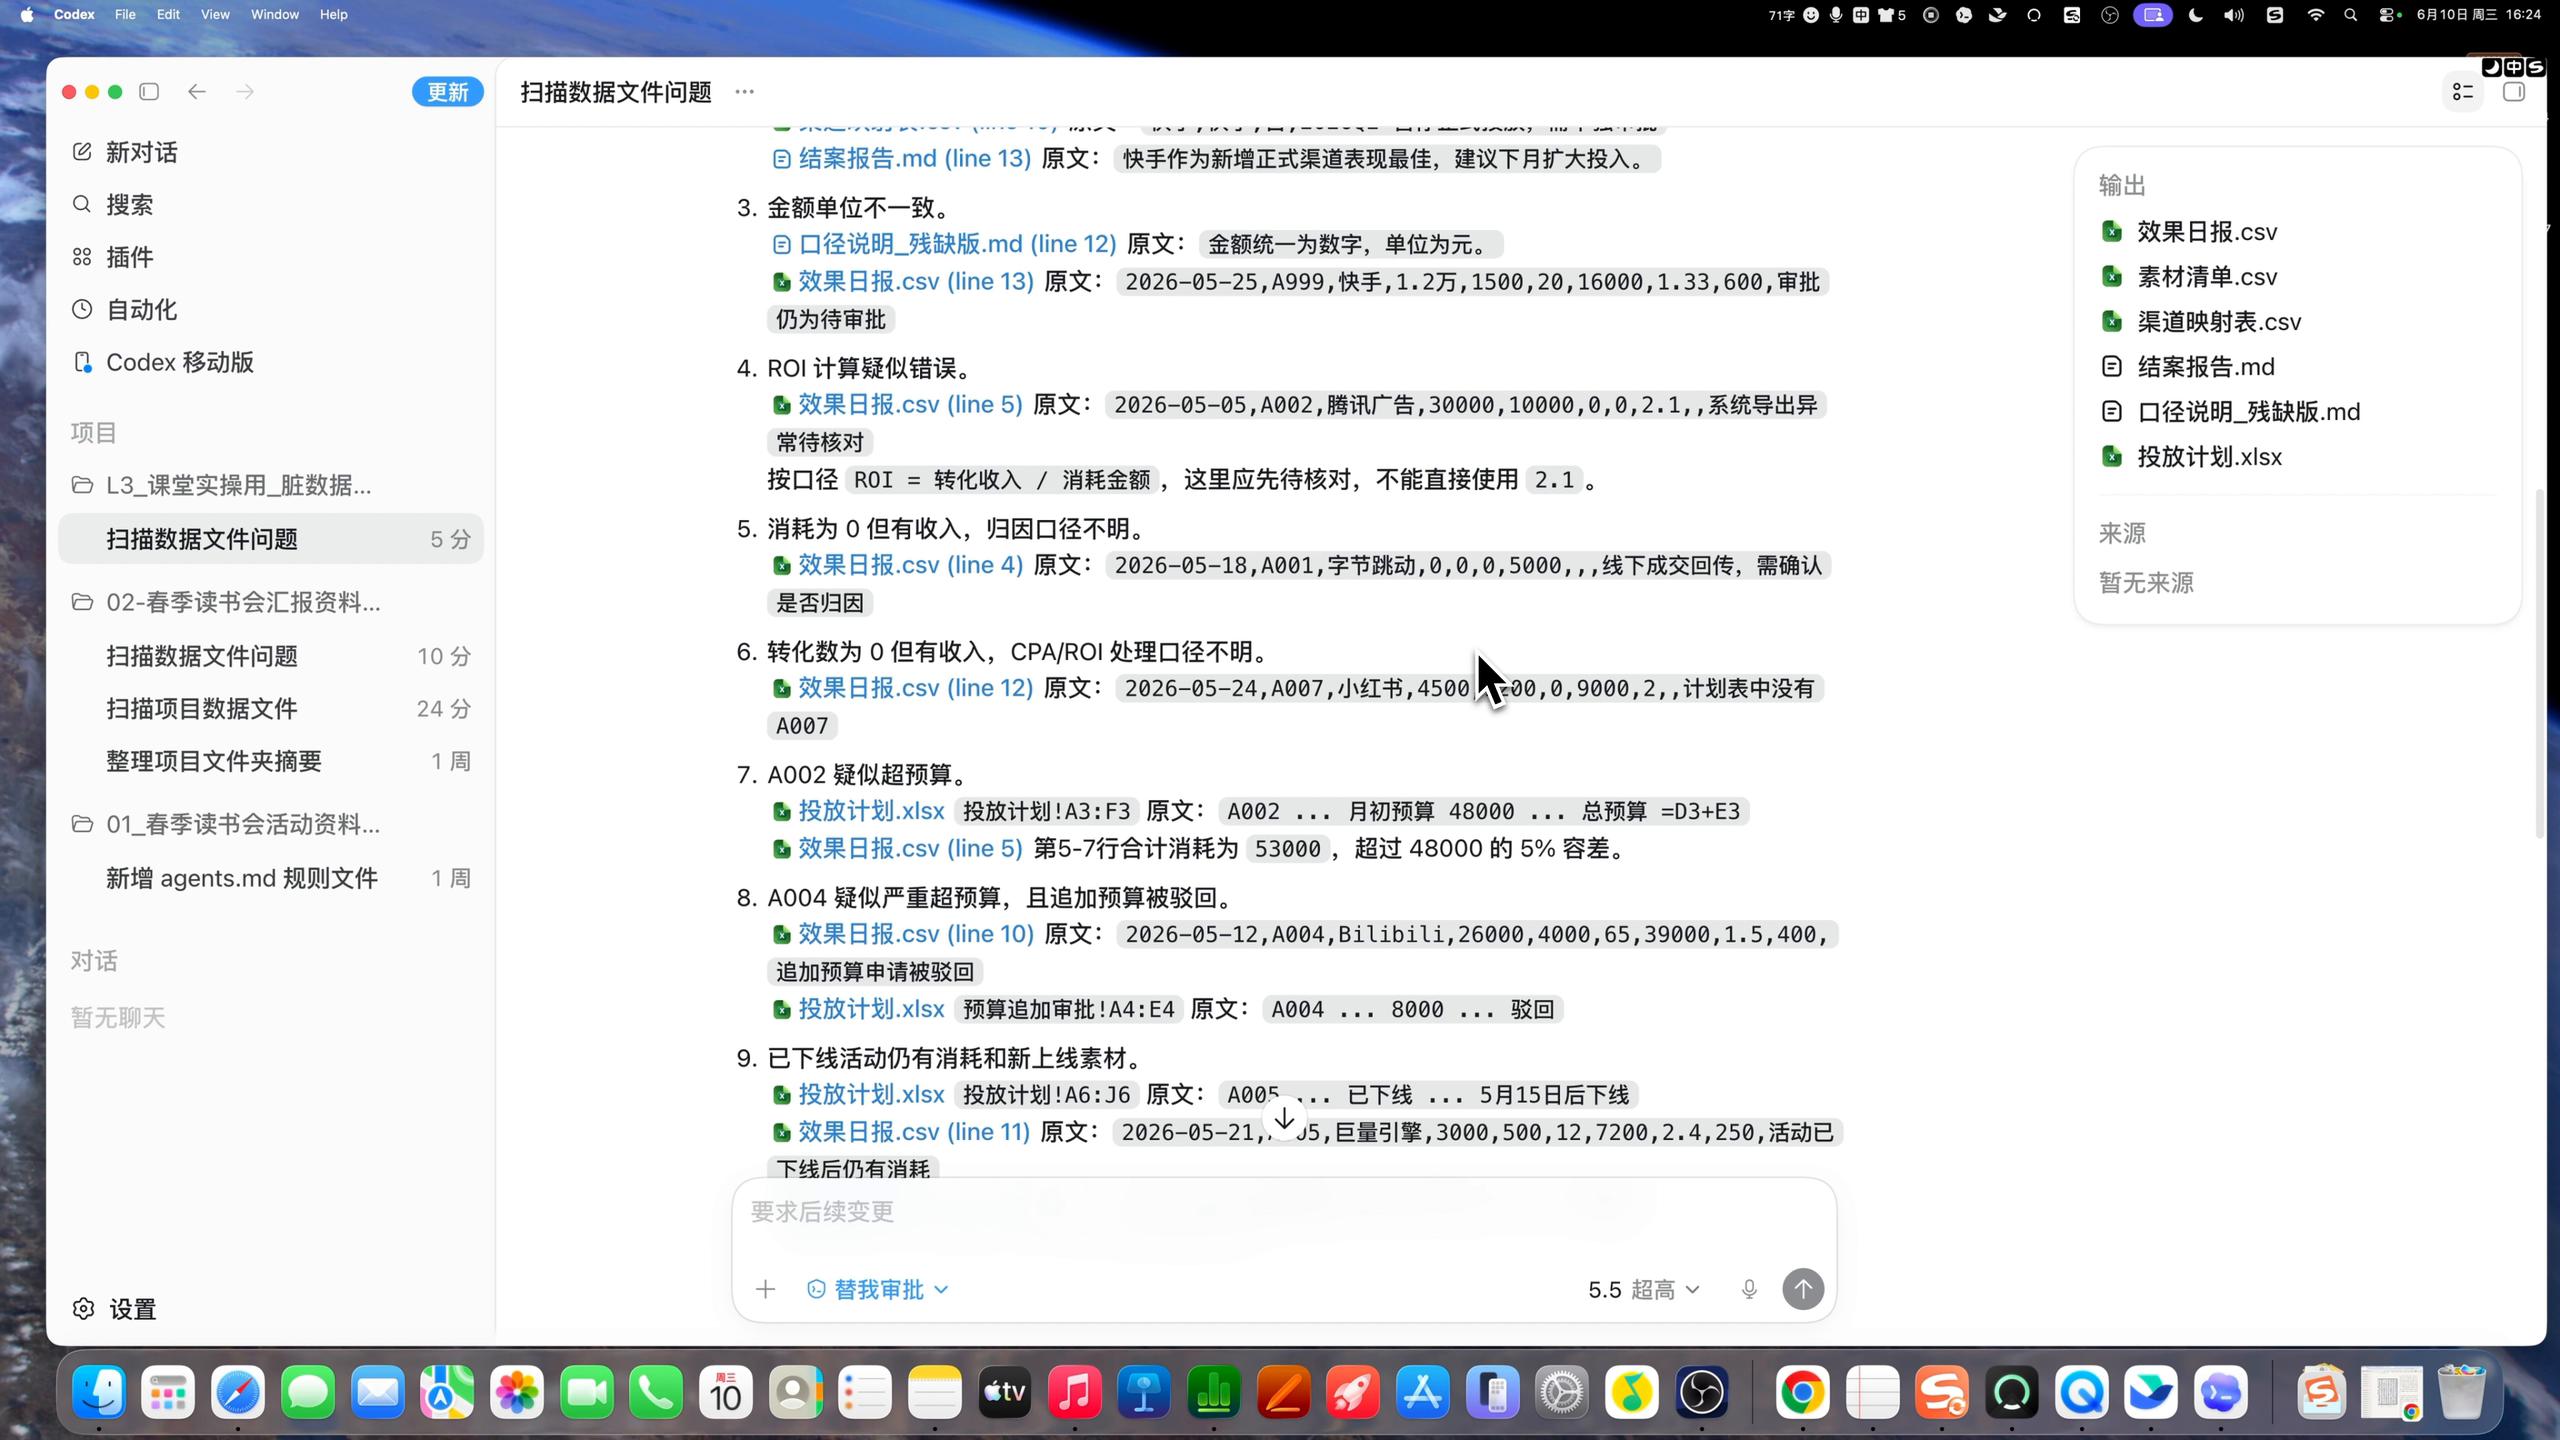
扫描后,Codex 会开始读取文件。你可以看到它识别出 CSV、Excel、
Markdown 等数据和说明文件,也会看到它只读不修改。第一轮输出
里,它可能已经发现渠道字段不一致、金额单位不一致、计算口径不明、
报告引用错误等问题。但这些还不是最终结论,只是待核实线索。
第二步:确认口径,把业务经验变成标准
只读扫描之后,下一步不是马上修复,而是让 Codex 先问最影响判断
的业务口径问题。
提示词可以这样写:
请根据刚才的只读扫描结果,先问我最影响检查结果的 5 个口径问题。
提问要求: 1. 只问 5 个,别一次性全问。 2. 每个问题都要带上你看
到的原文和具体位置。 3. 如果字段有多种写法,问我公司统一叫法。
- 如果数字看起来不合理,问我正常范围或例外条件。 5. 如果缺失值
不确定,问我是必填、可空,还是待补充。 6. 不要自己判断,不要自
己修复。
为什么要这样做?因为同一个数据,在不同公司、不同部门、不同项目
里,定义可能完全不一样。比如“日活”到底算付费用户还是全部用户,
“渠道”到底有哪些正式渠道,“金额”应该用元还是万元,“状态”
字段允许哪些值,这些都不能让 AI 凭感觉定。
演示里,Codex 问了 5 个关键问题。我们给它的回答大概是: