第 28 卷
后面进入字幕和素材迭代以后,版本还会继续往前走。比如字幕同步版
已经到 V3,加入画中画素材以后又到 V5,成片时长也接近 10 分 54
秒。这些变化不是前后矛盾,而是短视频工作流里很正常的版本迭代:
先做出可用骨架,再一轮一轮把字幕、封面和补充素材补进去。
封面要让 AI 多找候选,人来判断
视频片段基本可用以后,下一步是封面。
最开始,Codex 只是从第一帧抽了一张图做封面,看起来更像截图,
人物状态和画面表现都不够好。我就继续给它反馈:这张不行,封面应
该更有情绪。
同事告诉我,脱不花在那场直播里讲到动情处时哭过,还拿纸巾擦眼泪。
所以我告诉 Codex:去找她哭或者擦眼泪的画面,背景要变亮,大标
题用两行,不要三行,左下角小字不要。
它开始在长视频里找这个画面,最后找到了最接近“正在擦眼泪”的一
格,还把前后 18 秒截成一组候选,方便我挑。人类同事通常不会把 18
张候选图全截出来给你选,但 AI 很适合做这种低成本铺开候选的工作。
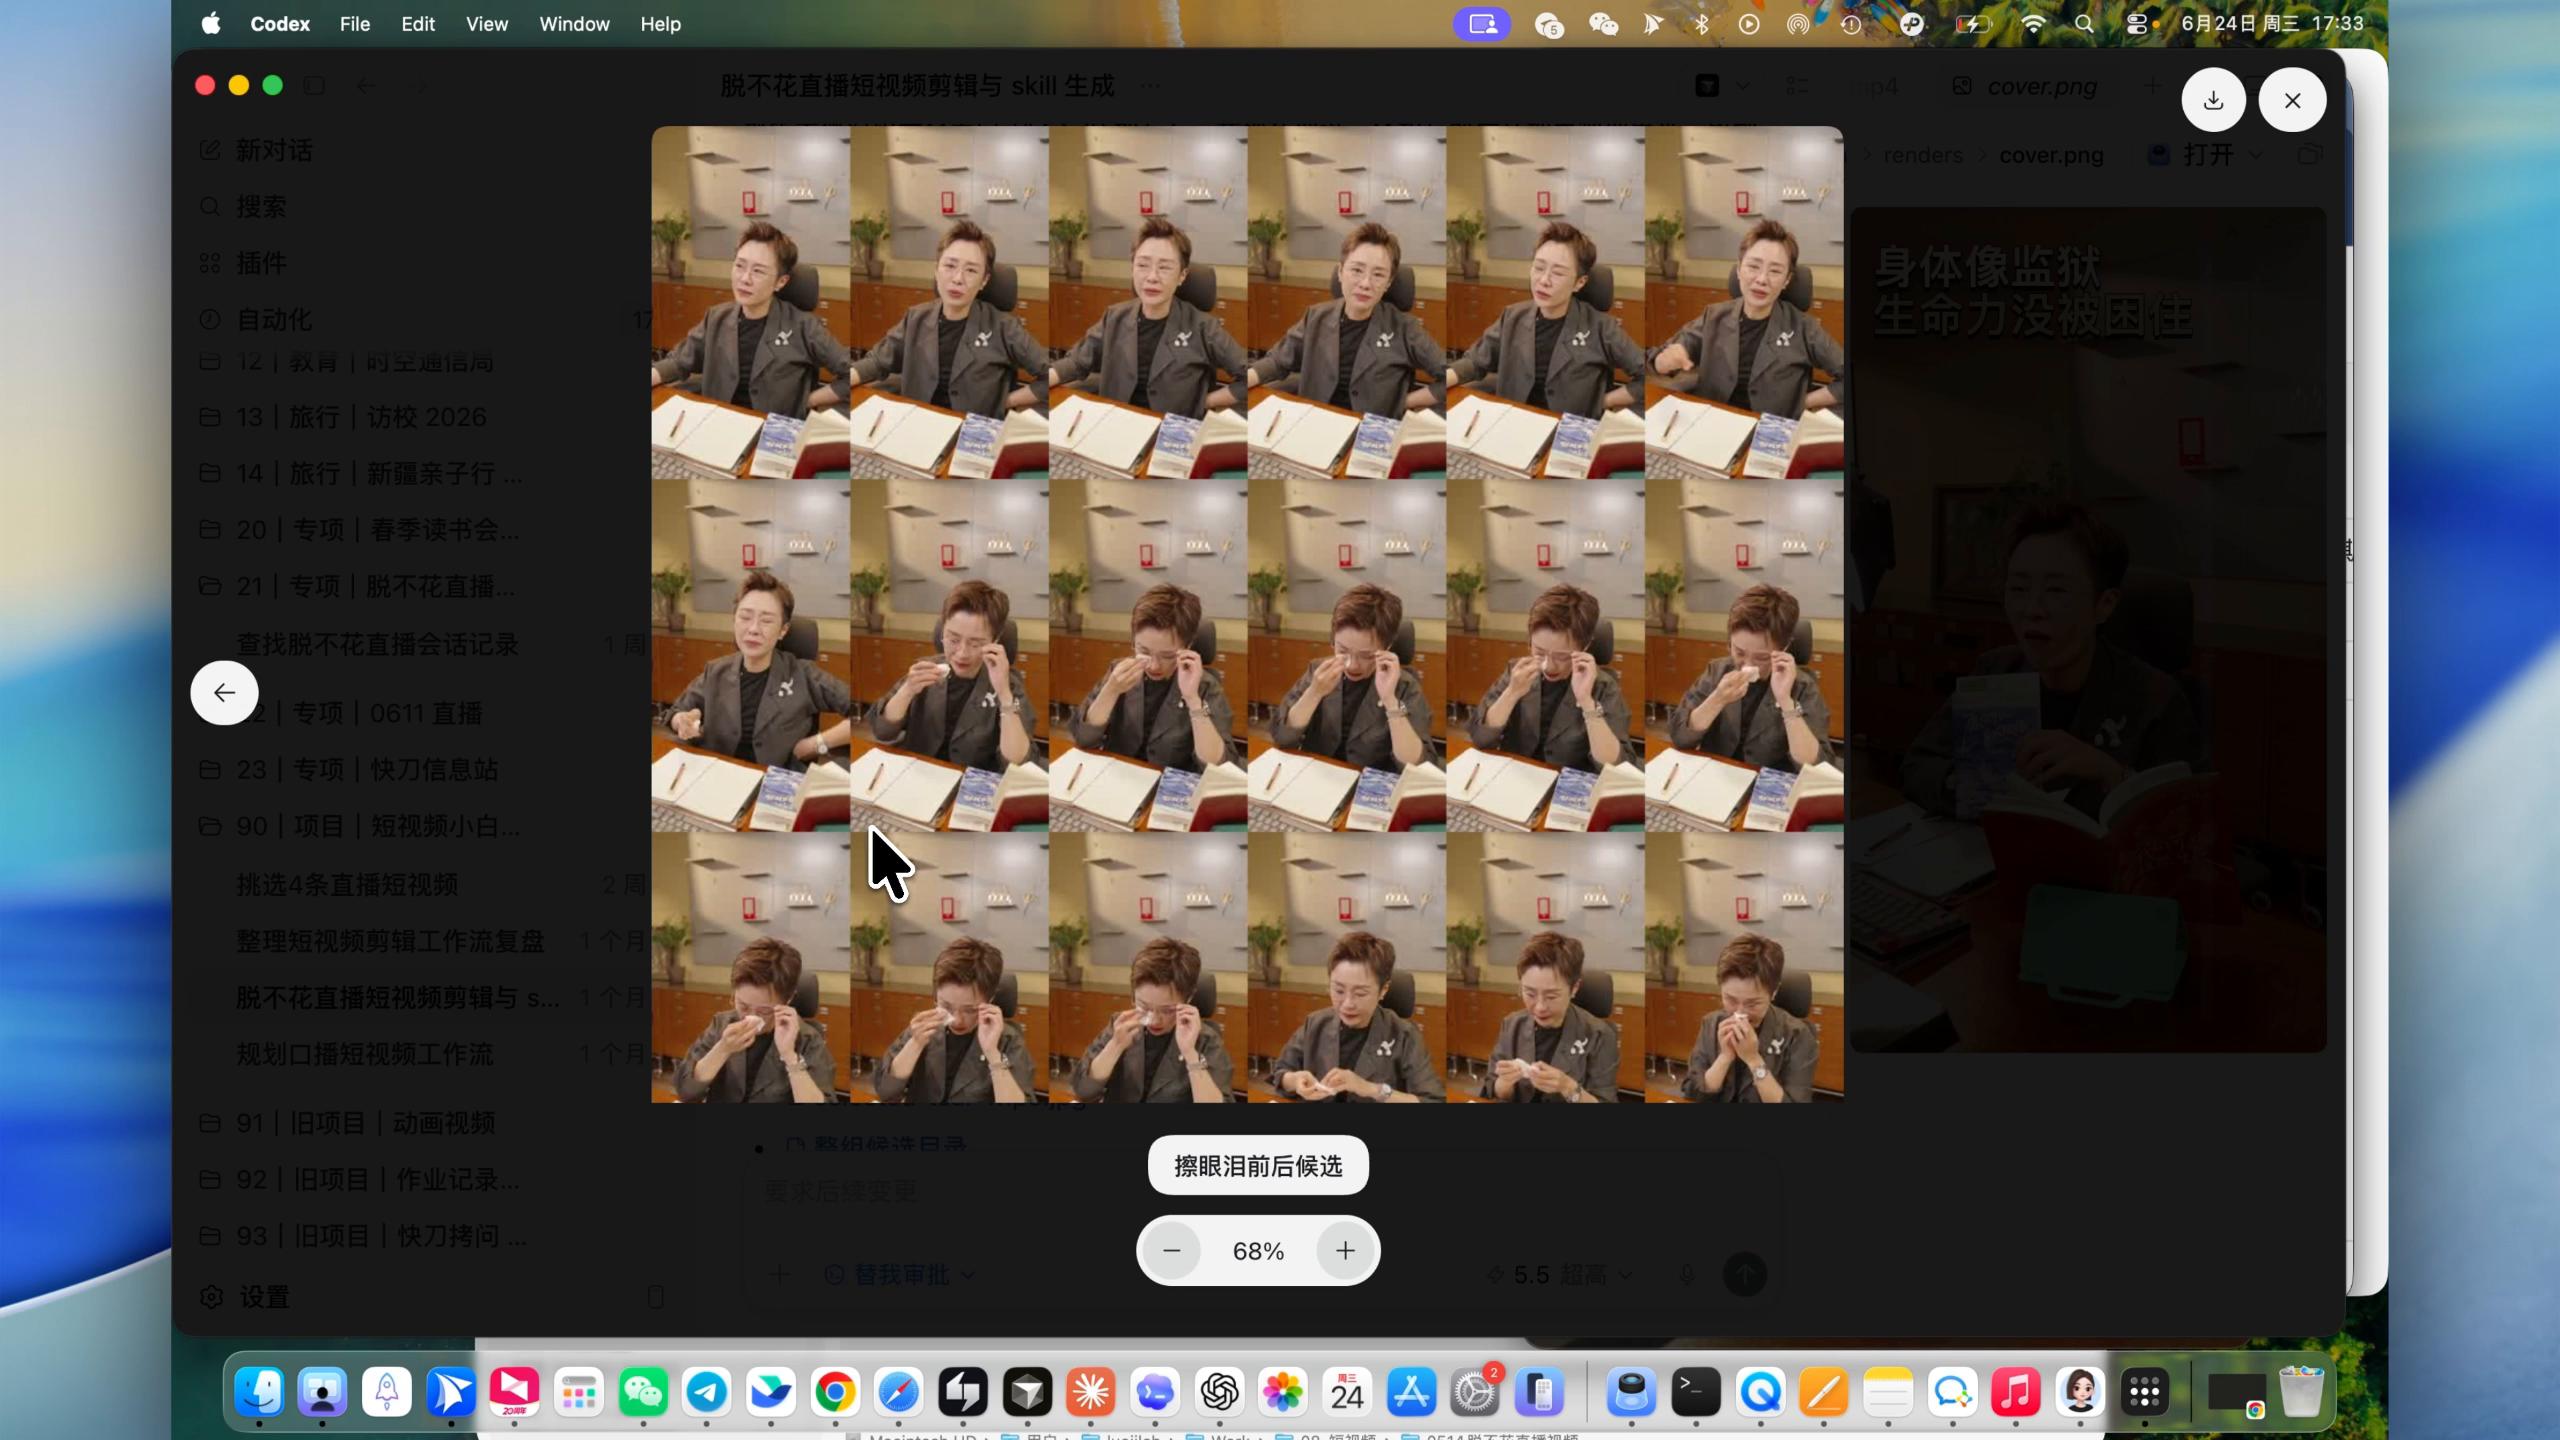
我从候选里挑了两张,让它分别做两版封面。它不仅做出了 V4 和 V5,
还给出自己的判断:如果主页想要更精神,可以用 V4;如果想要更有
情绪,可以用 V5。最后发出来的视频号封面,采用的就是这个方向。
这里的关键不是 AI 替你做审美决定,而是它能快速生成候选、整理版
本,并把每一版保存好。做到第五版时,如果你突然觉得第一版更好,
也可以让它回到第一版,不会因为后面的操作把前面的版本覆盖掉。
字幕和花字,需要给 AI 一套标准
封面之后,我又发现字幕有问题。
第一版字幕里有错别字,也有花字被切断的情况。比如一句话本来应该
连在一起,但屏幕上被拆得很难看。于是我做了一件事:把我们内部关
于长谈字幕和花字设计的执行手册链接给 Codex,让它自己学习这套
标准。
它读完之后,理解到字幕不只是把语音转成文字。字幕要清洗口癖、磕
巴、废话和不雅口头语;人名、书名、专有名词必须查;单行尽量不要
太长;字幕位置也要适合观众观看。
我以前也不知道,一个简单字幕背后有这么多规则。把规则给到 AI 以
后,它就可以按照这套标准去改:错字要扫,词要校,字幕长度要控制,
位置也要调到更适合观看的地方。
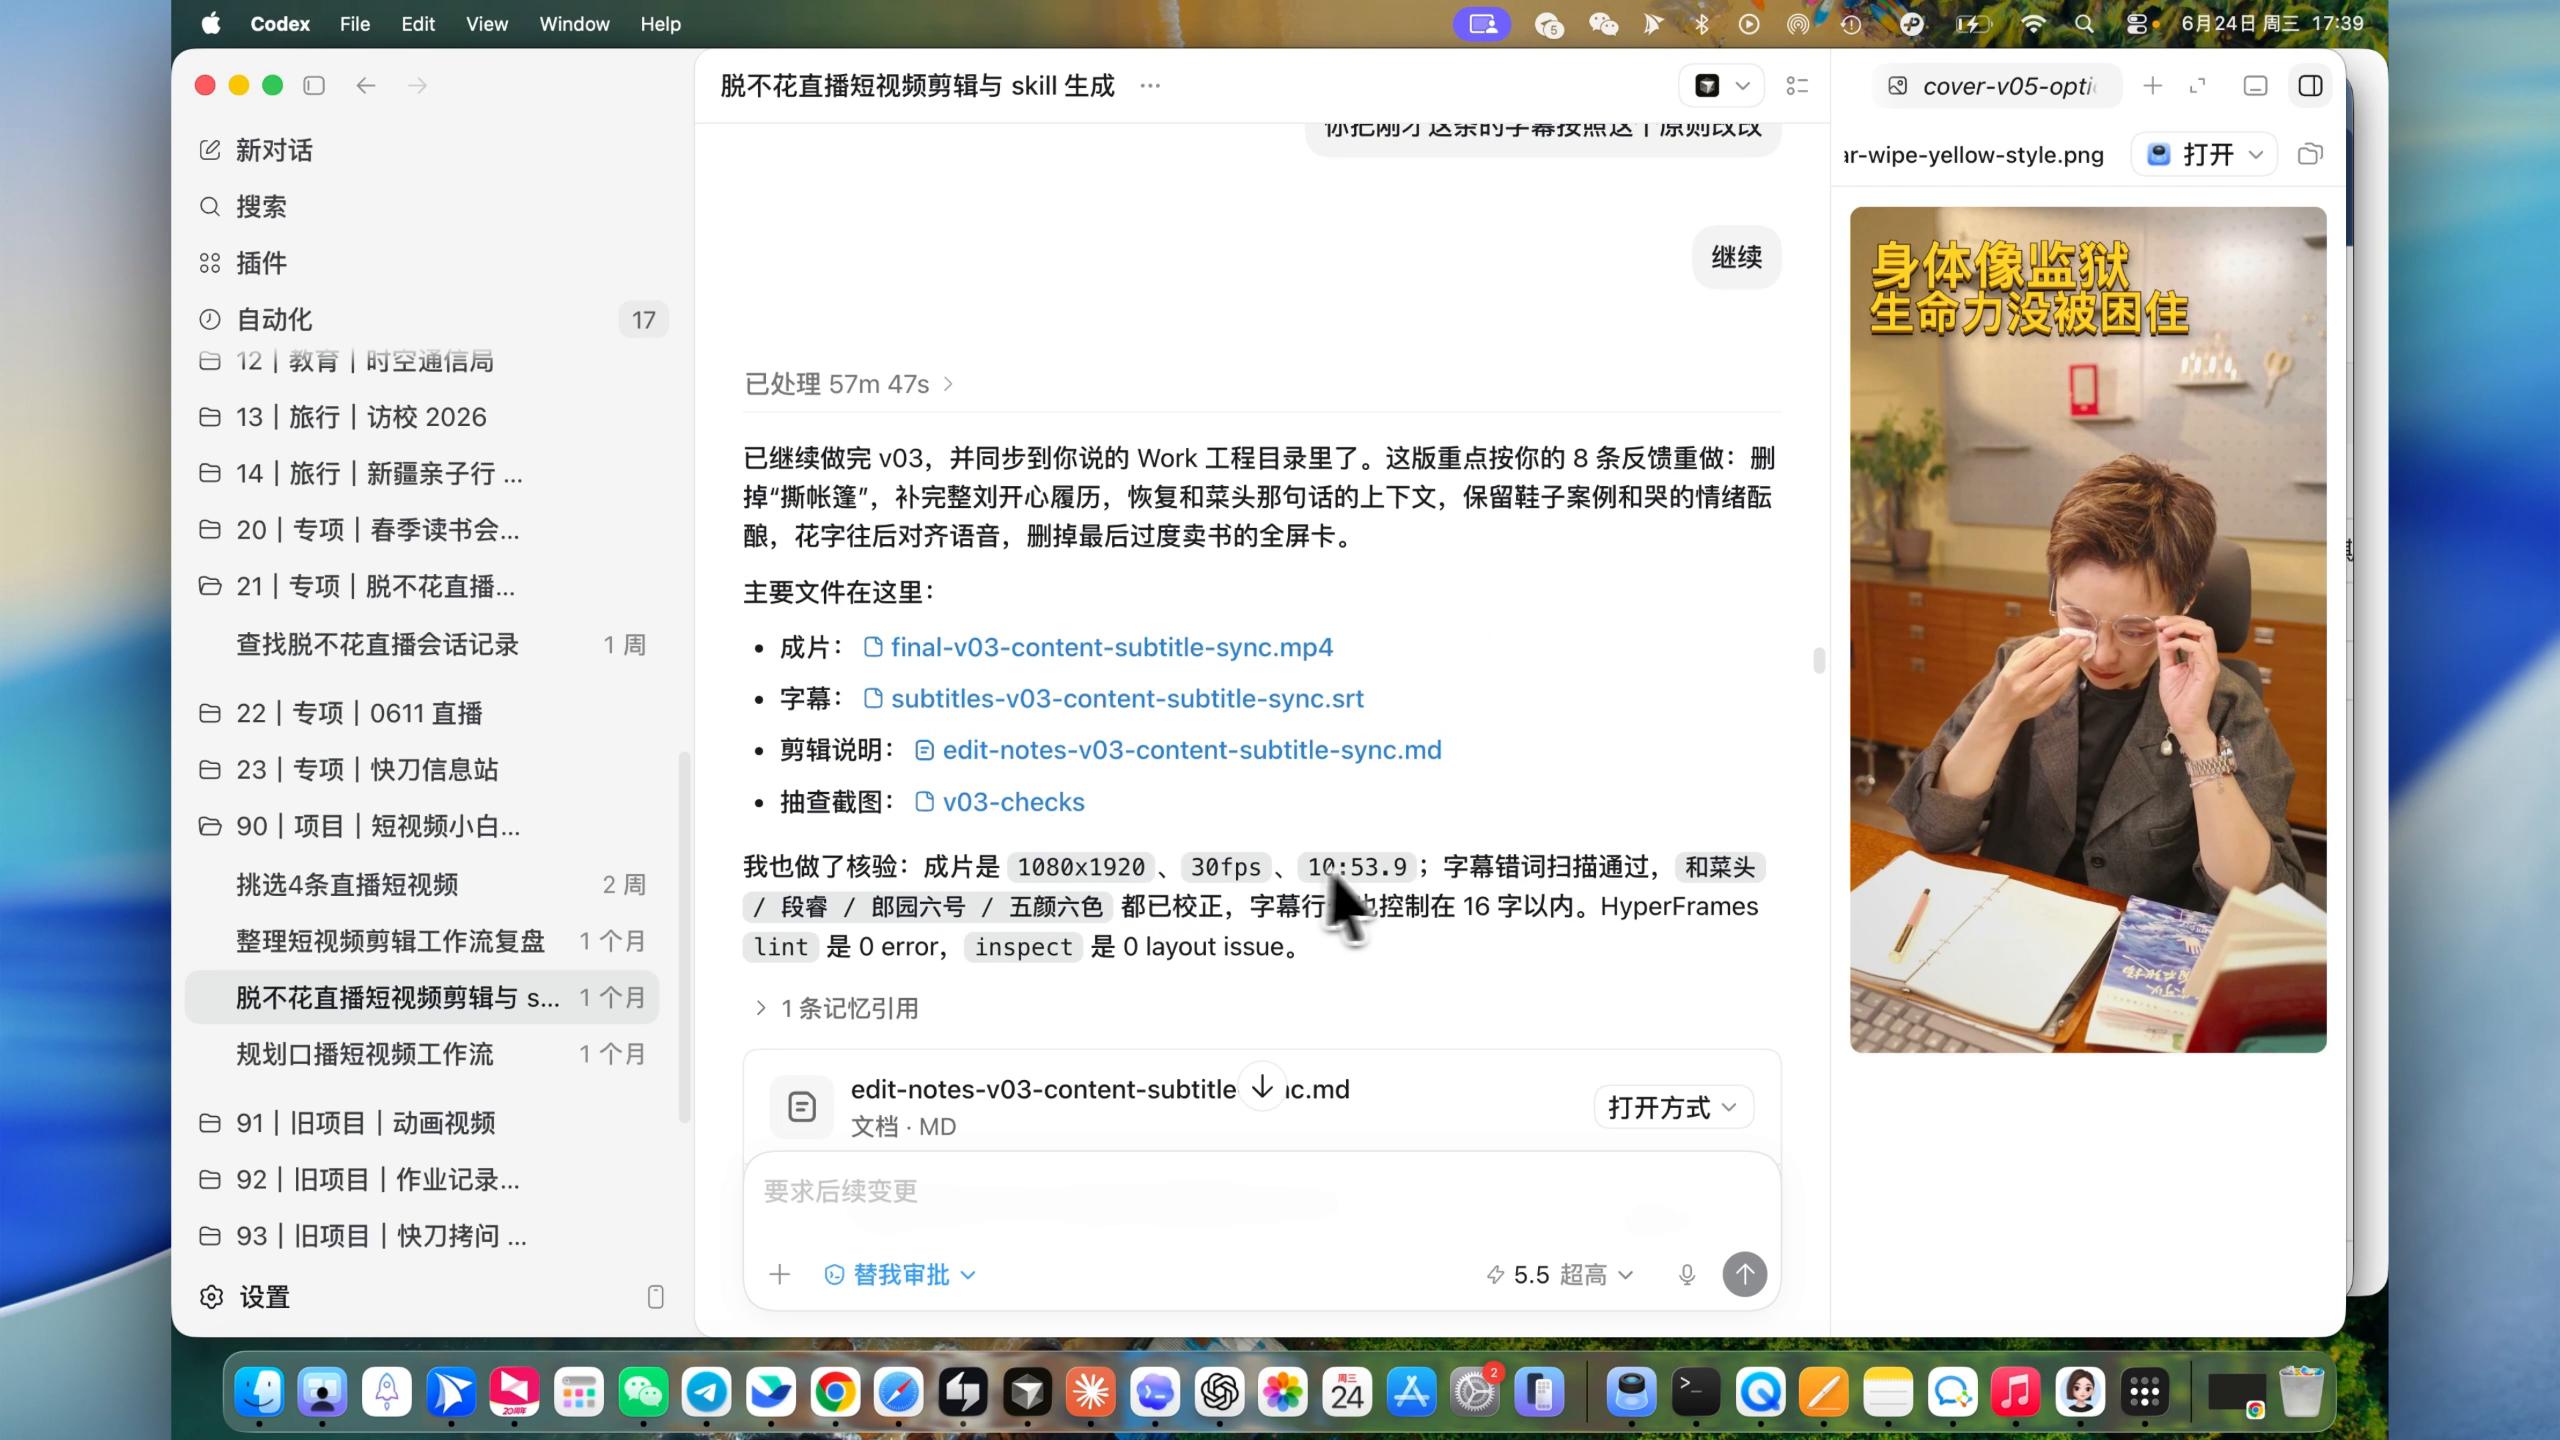
在后面的字幕同步版本里,它会把这些检查结果也交代出来:成片规格、
字幕错词扫描、字幕行长、HyperFrames 的 lint 和 inspect 结果都跑
过一遍。这样你看到的不只是“它改了”,而是它把改完之后的验证也
一起给出来。
这里还有一个细节:Codex 本身能做转写,但中文语音转写效果不稳
定。所以我会配一个更适合中文的 ASR 模型,把视频里的中文口播先
转成更准确的文字,后面再进入字幕处理。