9.从得到大脑到飞书,把Codex接入真实工作
以在本机电脑上完成很多工作,比如梳理文件夹、汇集资料、生成或剪辑短视频。
但我们的日常工作并不只发生在本地电脑里。所以这一讲,我们要让Codex从本地电脑里走出来,去调用更多软件和系统。今天这讲的重点不是某一个小功能,而是让大家理解:怎么把Codex连接到你
真实的工作流程里。
这讲我用一个具体案例来讲。很多同学都是得到大脑的用户,过去几年记了大量笔记。大家经常会提一个需求:AI来了以后,能不能从多年以前的笔记里,抽取一些我可能已经忘记的内容,让我和过
去的学习经历重新相遇?我们常把这种功能叫做“随机漫步”。
这一讲,我们就来做这样一个功能:让Codex先连接得到大脑,理解里面有哪些笔记,再每天随机抽取三条旧笔记,形成一份“记忆漫步日报”。这份日报可以是飞书文档,也可以是PPT,形式都可以按
你的需求来定。
这一讲真正想让大家理解的是:怎么把Codex用到自己的真实工作流程中。
让Codex连接得到大脑
我们先新建一个空白项目,项目名可以叫“笔记随机漫步”。
保存之后,第一步要做的事情,是让Codex读取得到大脑里的笔记。它要先知道有哪些笔记,后面才能随机抽取。
我们打开得到大脑官网,在页面上找到安装技能的提示词,先复制过来。这里我会做一个小调整:页面里原来的地址可以跑通,但会让AI多消耗一些token,没有必要。我们可以直接使用GitHub上最新
的技能仓库地址。
把页面往下拉,找到CLI命令行下面的GitHub仓库,把仓库地址复制下来,替换到提示词里。
如果你是新手用户,以前没接触过这些工具,可以在提示词里加一句话,让Codex每一步都用大白话解释你要做什么。比如:
请安装得到大脑技能,帮我记录和查找笔记。技能地址:https://github.com/iswalle/getnote-cli 安装的过程中,每一步都需要用大白话告诉我需要做什么。
装好之后,只要做一件事,就是告诉我这个笔记库里一共有多少条笔记,不要读具体的内容。
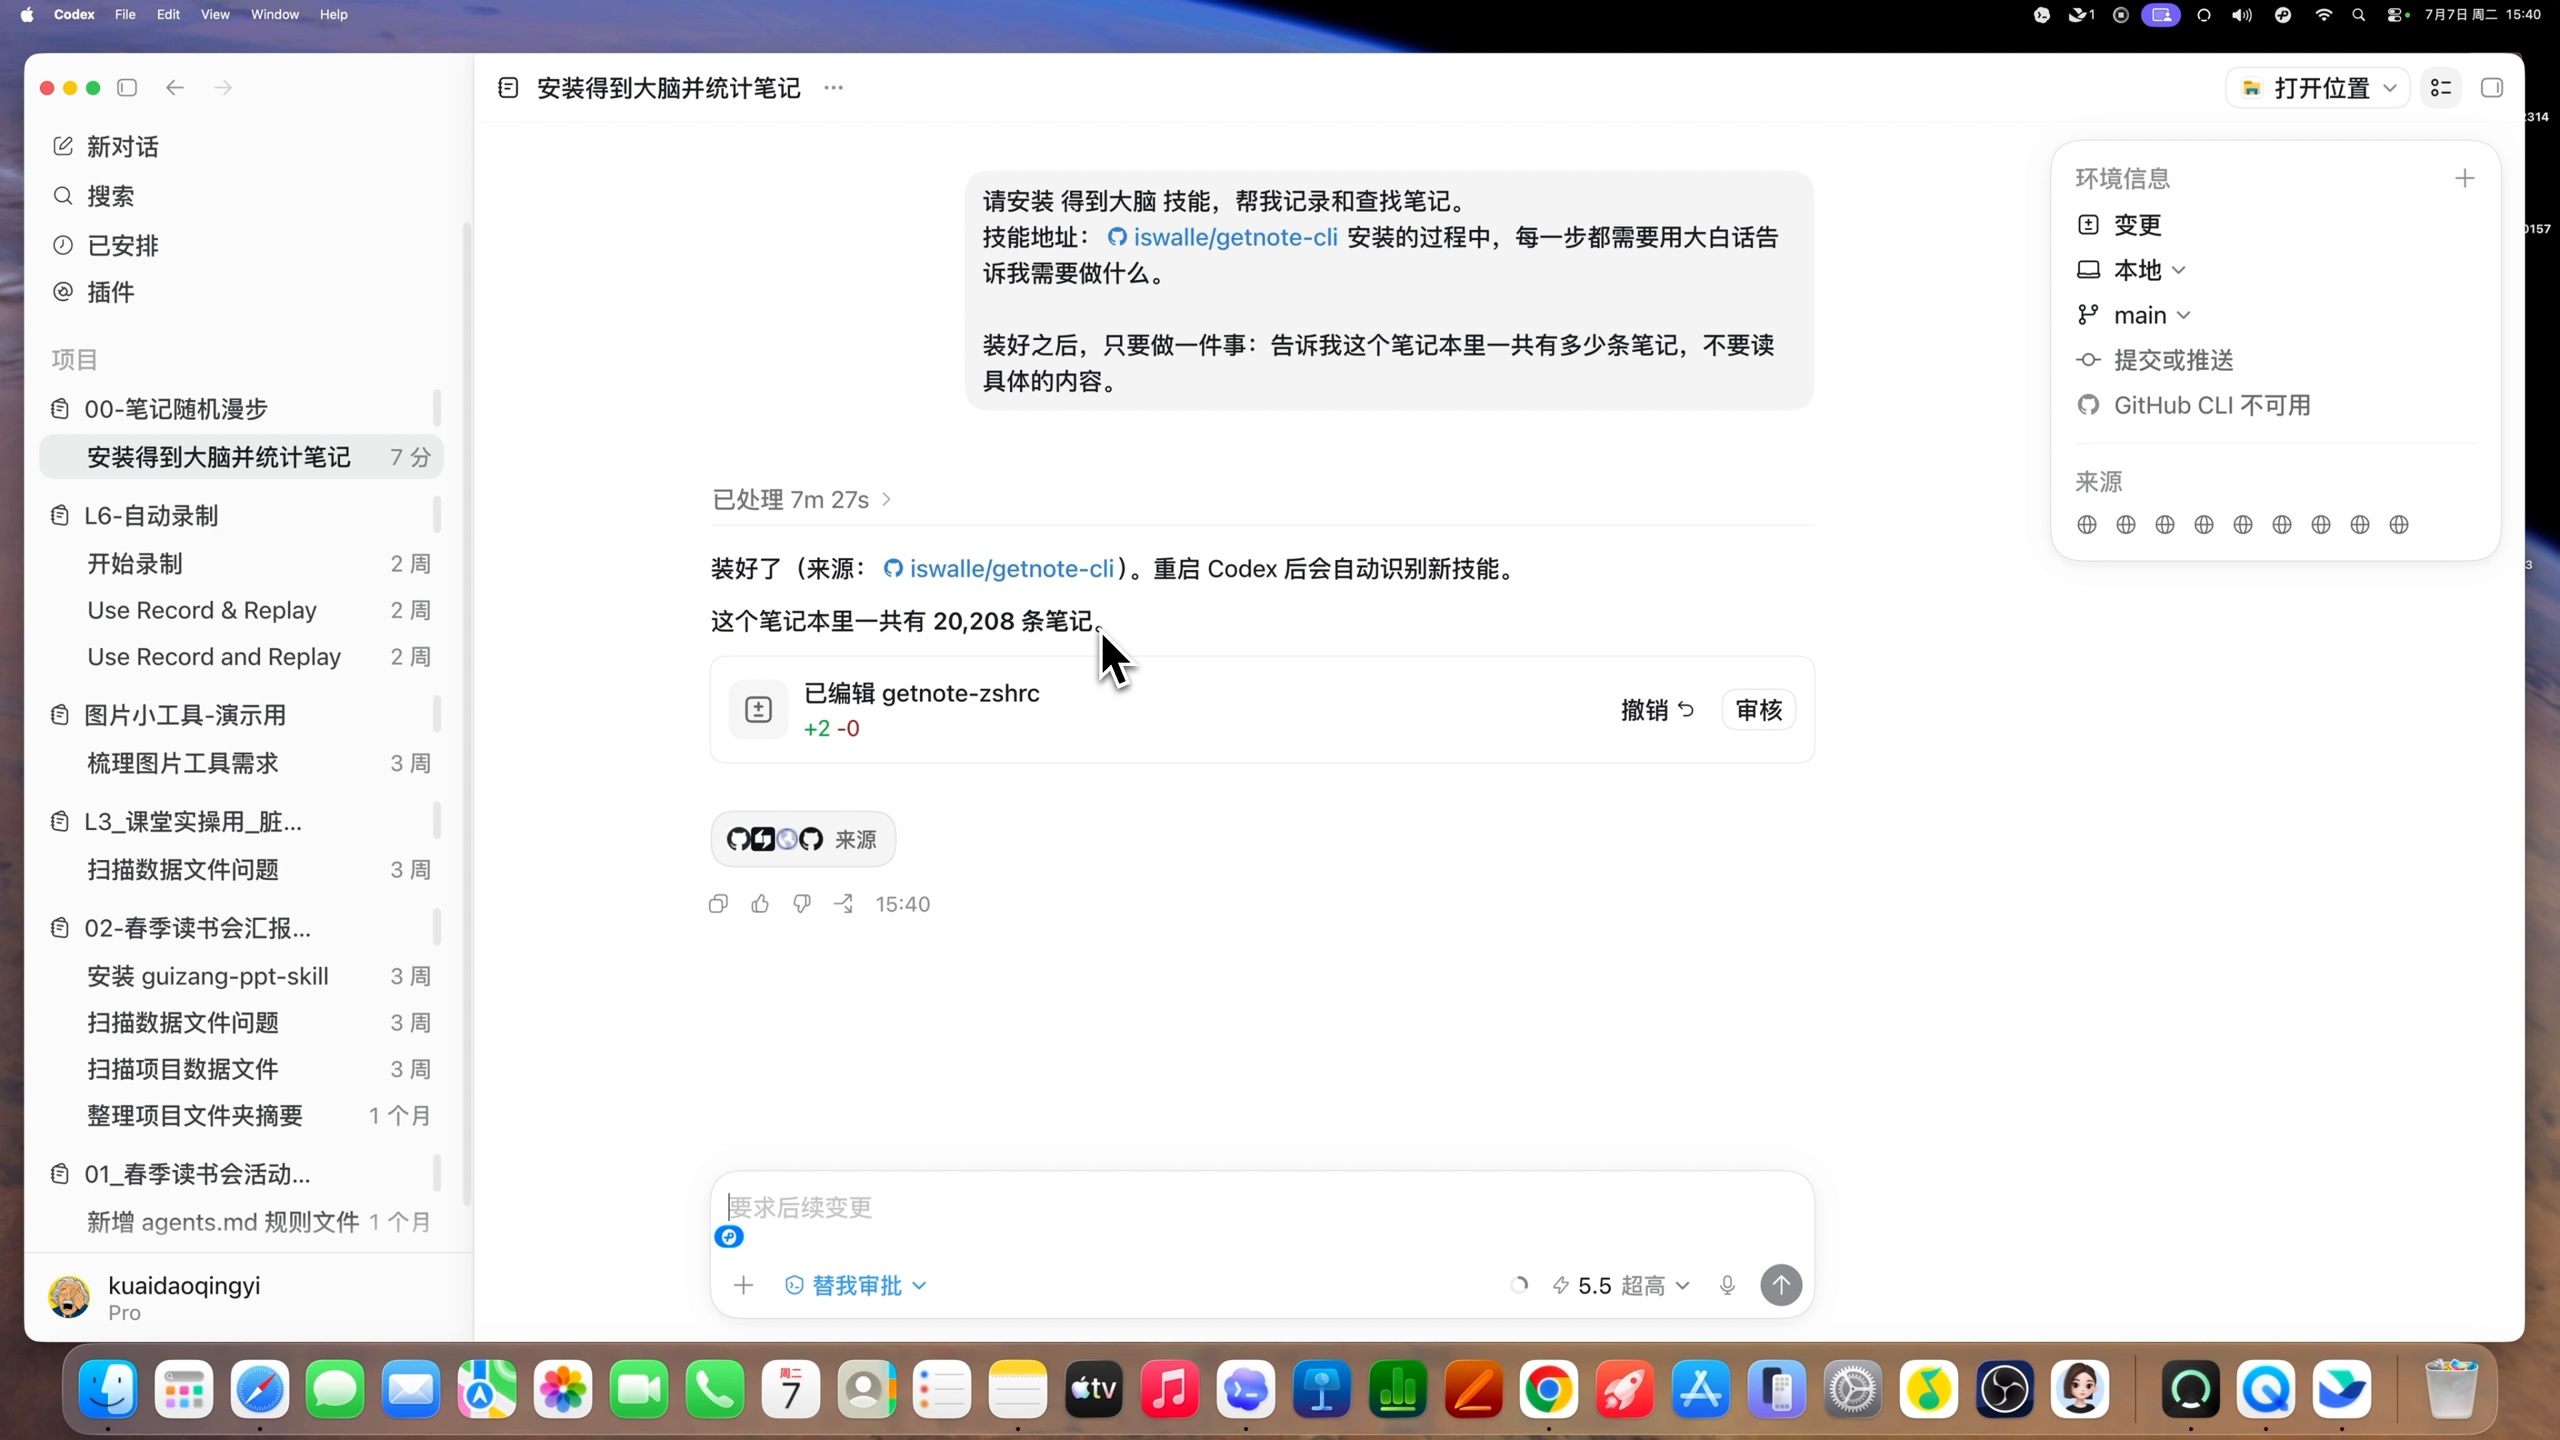
这句话的意思是:先把技能装好,装好以后先测试能不能连通。只要Codex能读到笔记总数,就证明连接已经完成了。
发出去之后,如果你用的是一台全新的电脑,可能会发现很多常用工具还没有安装。这个不用担心,Codex会自己一步一步想办法解决这些问题。

安装完成后,如果还没有登录,它会弹出授权流程。你可以用微信扫码,也可以用手机号登录。授权
重启之后,Codex会自动识别新技能。接下来,我们进入第二步。
先跑通一次随机漫步
很多时候,我们和AI交互,不要指望一次就把事情全部做完。更好的方式是先让它跑一个小版本,一点一点调试。
我先让它从笔记库里随机抽三条不同时期的笔记,要求是:
请从我的大脑里面,所有笔记里面,随机抽取三条不同时期的笔记。
第一,只读笔记,不要做任何修改,也不要做任何删除动作。
第二,每条给出我原文的摘录,不能太简略,并且要记录这条笔记的时间。
第三,尽量分散在不同的年份或者月份,不要都抽最近的。
这个任务跑起来可能会比较慢。我的笔记量太大,所以它一开始跑了很久。这个时候正好可以给大家演示:如果正在跑的任务中间,你有新的需求,或者想调整条件,应该怎么及时插入新需求。
比如,我发现最近两年的笔记产量很大,如果不加限制,随机结果可能会过于集中。我就可以调整需求,让随机漫步都从2016年到2022年中抽取。发出新要求后,可以通过引导让Codex按新的需求打断
并重新执行。
因为我的笔记很多,即便只限定几年,中间也有1000多条笔记。后来我又进一步增加限制,让它从得到电子书的书摘笔记中抽取三条。
最后它给我随机抽到了三条:一条是关于《伊隆·马斯克传》的短摘录,一条是《历史的温度》,还有一条是关于弦理论的书摘。
把短摘录扩成可回顾的材料
只看短摘录,有时候会觉得内容太单薄。比如抽到《伊隆·马斯克传》的那条笔记时,我看到摘录,但已经不太记得这本书具体讲了什么。
所以我继续追问:
就这三条笔记内容,短摘录内容太单薄,给我扩充一下原文。
扩充之后,内容就更有回忆价值了。比如它会补充马斯克在TED演讲里谈到童年经历,也会解释“白痴指数”这个概念:用来计算某个制成品的成本比基础材料成本高出多少。如果一个产品的白痴指数
足够高,就意味着存在用更好制造技术降低成本的空间。
人用来定标准,AI用来执行。
定义记忆漫步日报
对我来说,单纯列出三条笔记还不够。我希望把它变成一份每天的记忆漫步日报。于是,我先制定日报格式:
我想把这样的每天的随机漫步的笔记结果做成一份记忆漫步日报,格式由我来制定。
第一,标题必须带有日期。
第二,每条笔记要包含原文摘录、记录时间,并且用两三句话说明为什么这条笔记值得回顾。
第三,结尾根据这三条笔记和我最近一个星期关心的事情之间有什么关联,写一个简单说明。
先按照这三个格式要求,用刚才的三条笔记生成一份预览给我。
这样生成出来的就不只是三条旧笔记,而是一份“记忆漫步日报”。
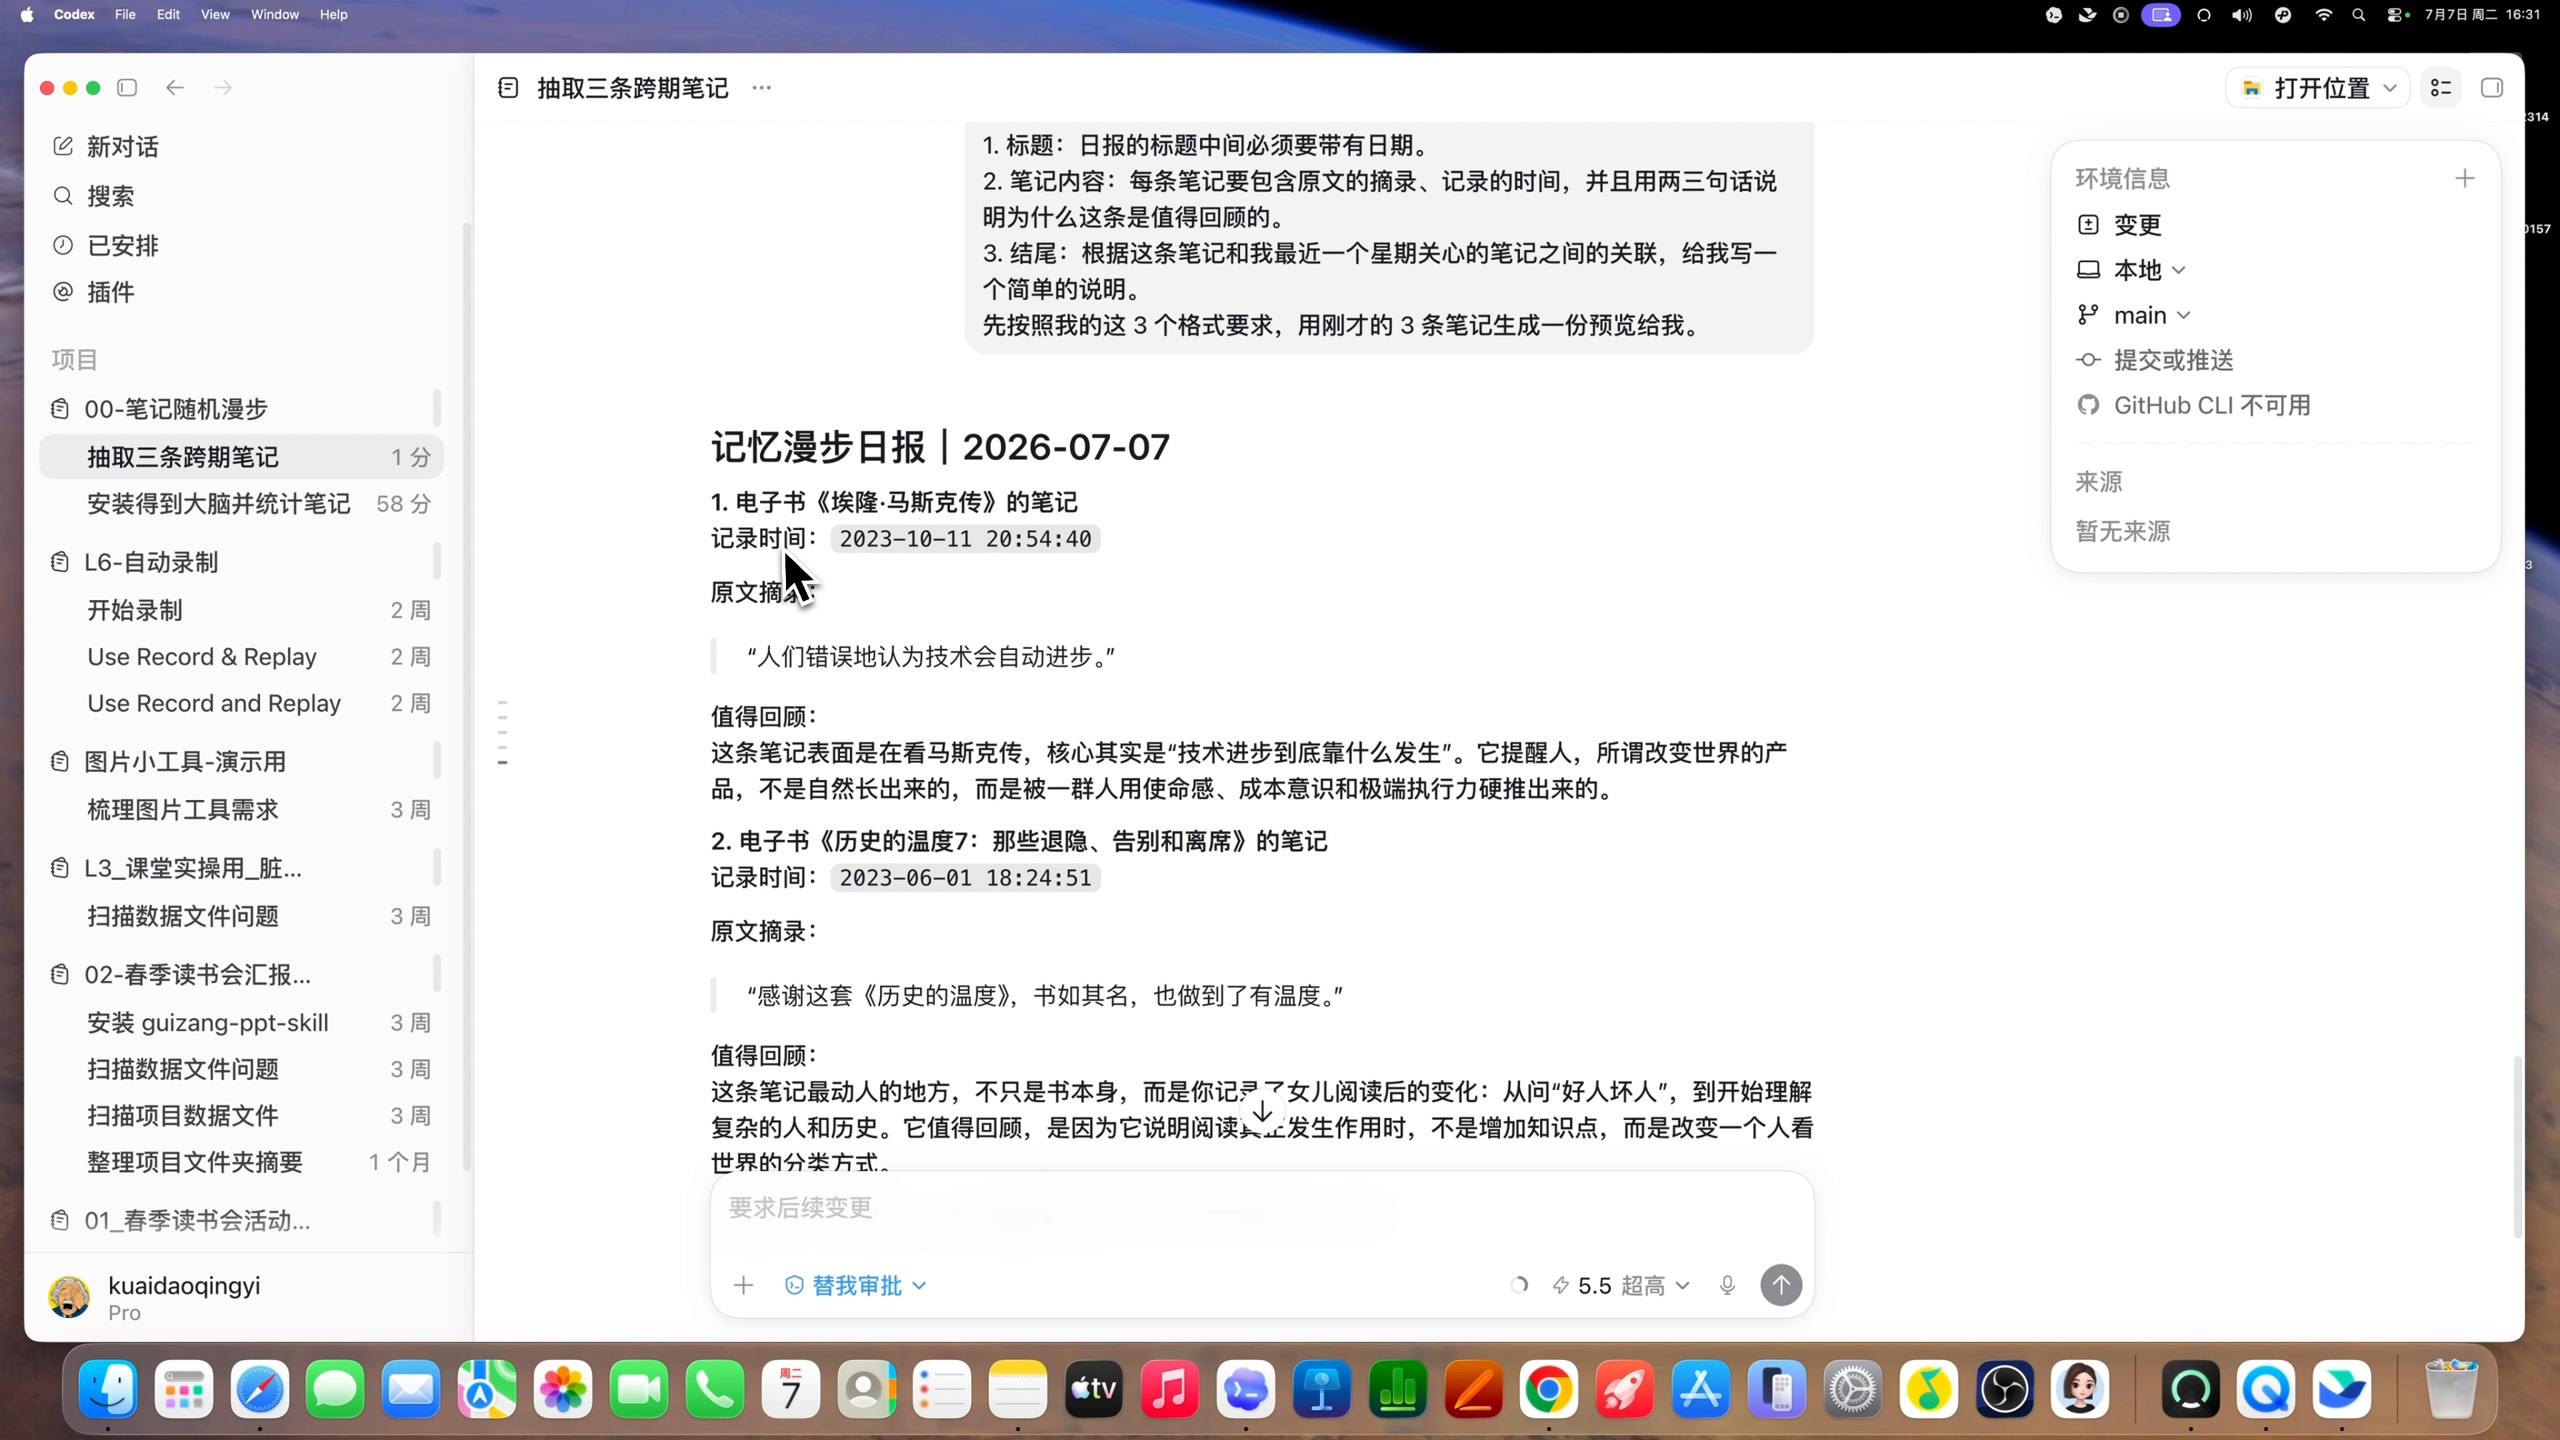
它会列出日期,列出每条电子书笔记的记录时间和原文摘录,也会解释为什么值得回顾。最后,它还会把这些旧笔记和我最近一周关心的事情联系起来,比如AI组织变革、得到大脑、电子阅读等议
题。
生了哪些变化?这些都可以根据自己的需求继续让AI分析。
把日报变成PPT
可能每个人对日报的呈现形式都不一样。比如,这样一份日报能不能变成类似PPT的形态?
我们之前用过PPT相关的skill,这里可以继续把它唤起,让它把“记忆漫步日报”做成PPT。我的要求是:因为这是日报,所以视觉呈现风格更像传统报纸或杂志。
完成后,它生成了一个版本,风格接近电子杂志或电子墨水模板,选用了牛皮纸质感。刚才那份文字版的三条笔记,被做成了一个6页左右的PPT,可以左右翻页。
PPT Skill地址:https://github.com/op7418/guizang-ppt-skill
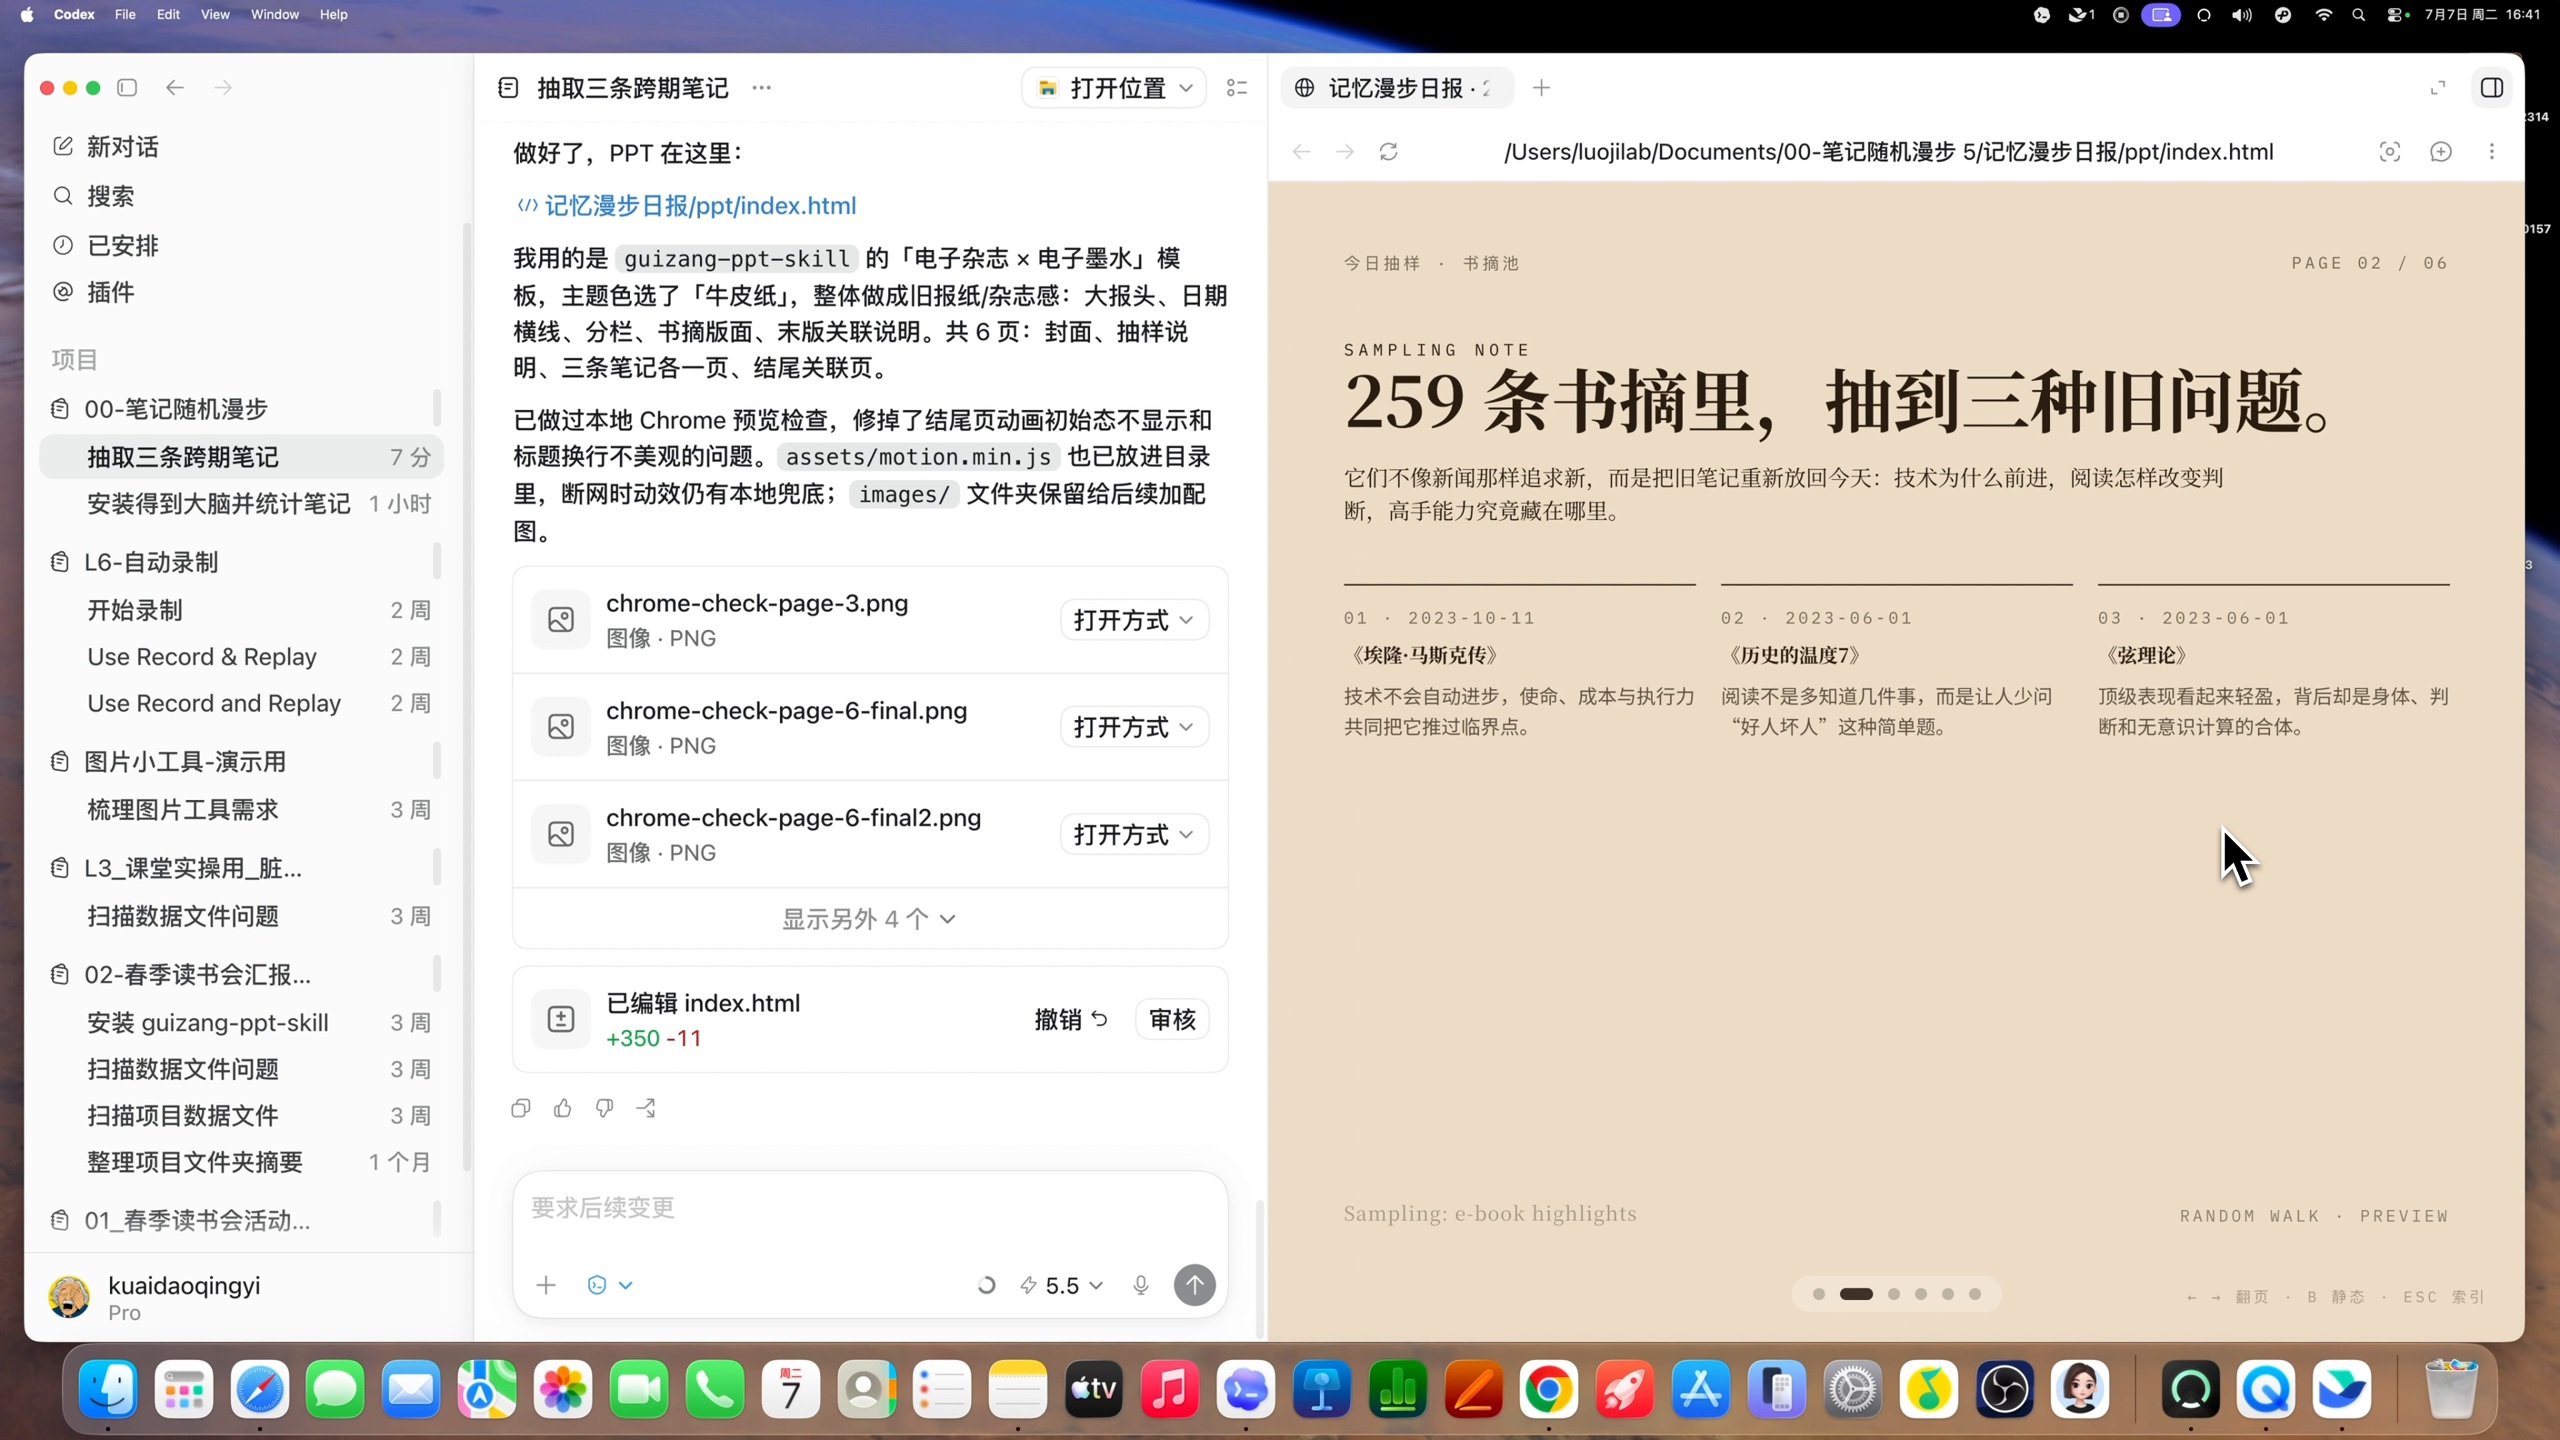
它会先把三条笔记抽成三个问题,再分别展开《伊隆·马斯克传》《历史的温度》和《弦理论》那几条笔记,最后再做一个结尾。这样,原来纯文本的回答,就变成了一个可视化结果。
如果你对模板里的某些部分不满意,也可以直接用注释改。比如我觉得“记忆漫步日报”的页脚不需要保留,就选中相应位置,加一条注释:不要这个页脚。发出去之后,它就会把页脚删除。
这就是通过可视化方式继续调整日报。
把日报放进协作系统
钉钉、企微也是同样的逻辑。现在很多协作软件都有自己的CLI或开放接又,可以让agent完成过去只能在软件界面里完成的工作。
这里我先让Codex学习如何调用飞书,并新建文档。飞书命令行工具安装完成后,还要完成登录授权。因为系统必须知道:这是谁的飞书账号,这篇文档要以谁的名义创建。
飞书Cli官方网址:https://www.feishu.cn/feishu-cli
我会用大白话让它一步一步引导登录,并明确告诉它:
帮我安装飞书 CLI:https://open.feishu.cn/document/no_class/mcp-archive/feishu-cli-installationguide.md我希望在飞书里边新建一篇飞书文档,内容是我刚才确认下来的记忆漫步日报。
标题用“记忆漫步日报”加今天日期的形式。
一定只新建文档,不允许改我以前的文档。
最后生成完之后,给我一个预览地址。
这条要求里有一个非常重要的边界:只新建文档,不修改已有文档。
授权完成后,它就可以生成飞书文档。打开预览链接,你就能看到一篇“记忆漫步日报”,里面有标题、几条笔记、值得回顾的理由,以及和最近关心问题的关联。
这样,一个本地笔记库里的随机抽取结果,就进入了真实工作流,可以直接分享给同事。
封装成skill和定时任务
到这里,我们已经完成了一次完整流程:从笔记库里随机抽取三条笔记,生成日报,变成PPT,再生成可以转发的飞书文档。
但如果每次都手动跑一遍,流程还是太长。最后一步,就是把刚才所有事情封装成一个skill,让AI自动来跑。
我直接对Codex说:
请把刚才这套流程封装成一个skill技能。
中文命名可以叫做随机漫步。
它的核心逻辑就是从得到大脑的笔记库里随机抽取三条笔记,按照我定的格式生成日报,并且新建一个飞书文档。
封装完之后,帮我新建一个定时任务,每天早上8点自动执行一次。
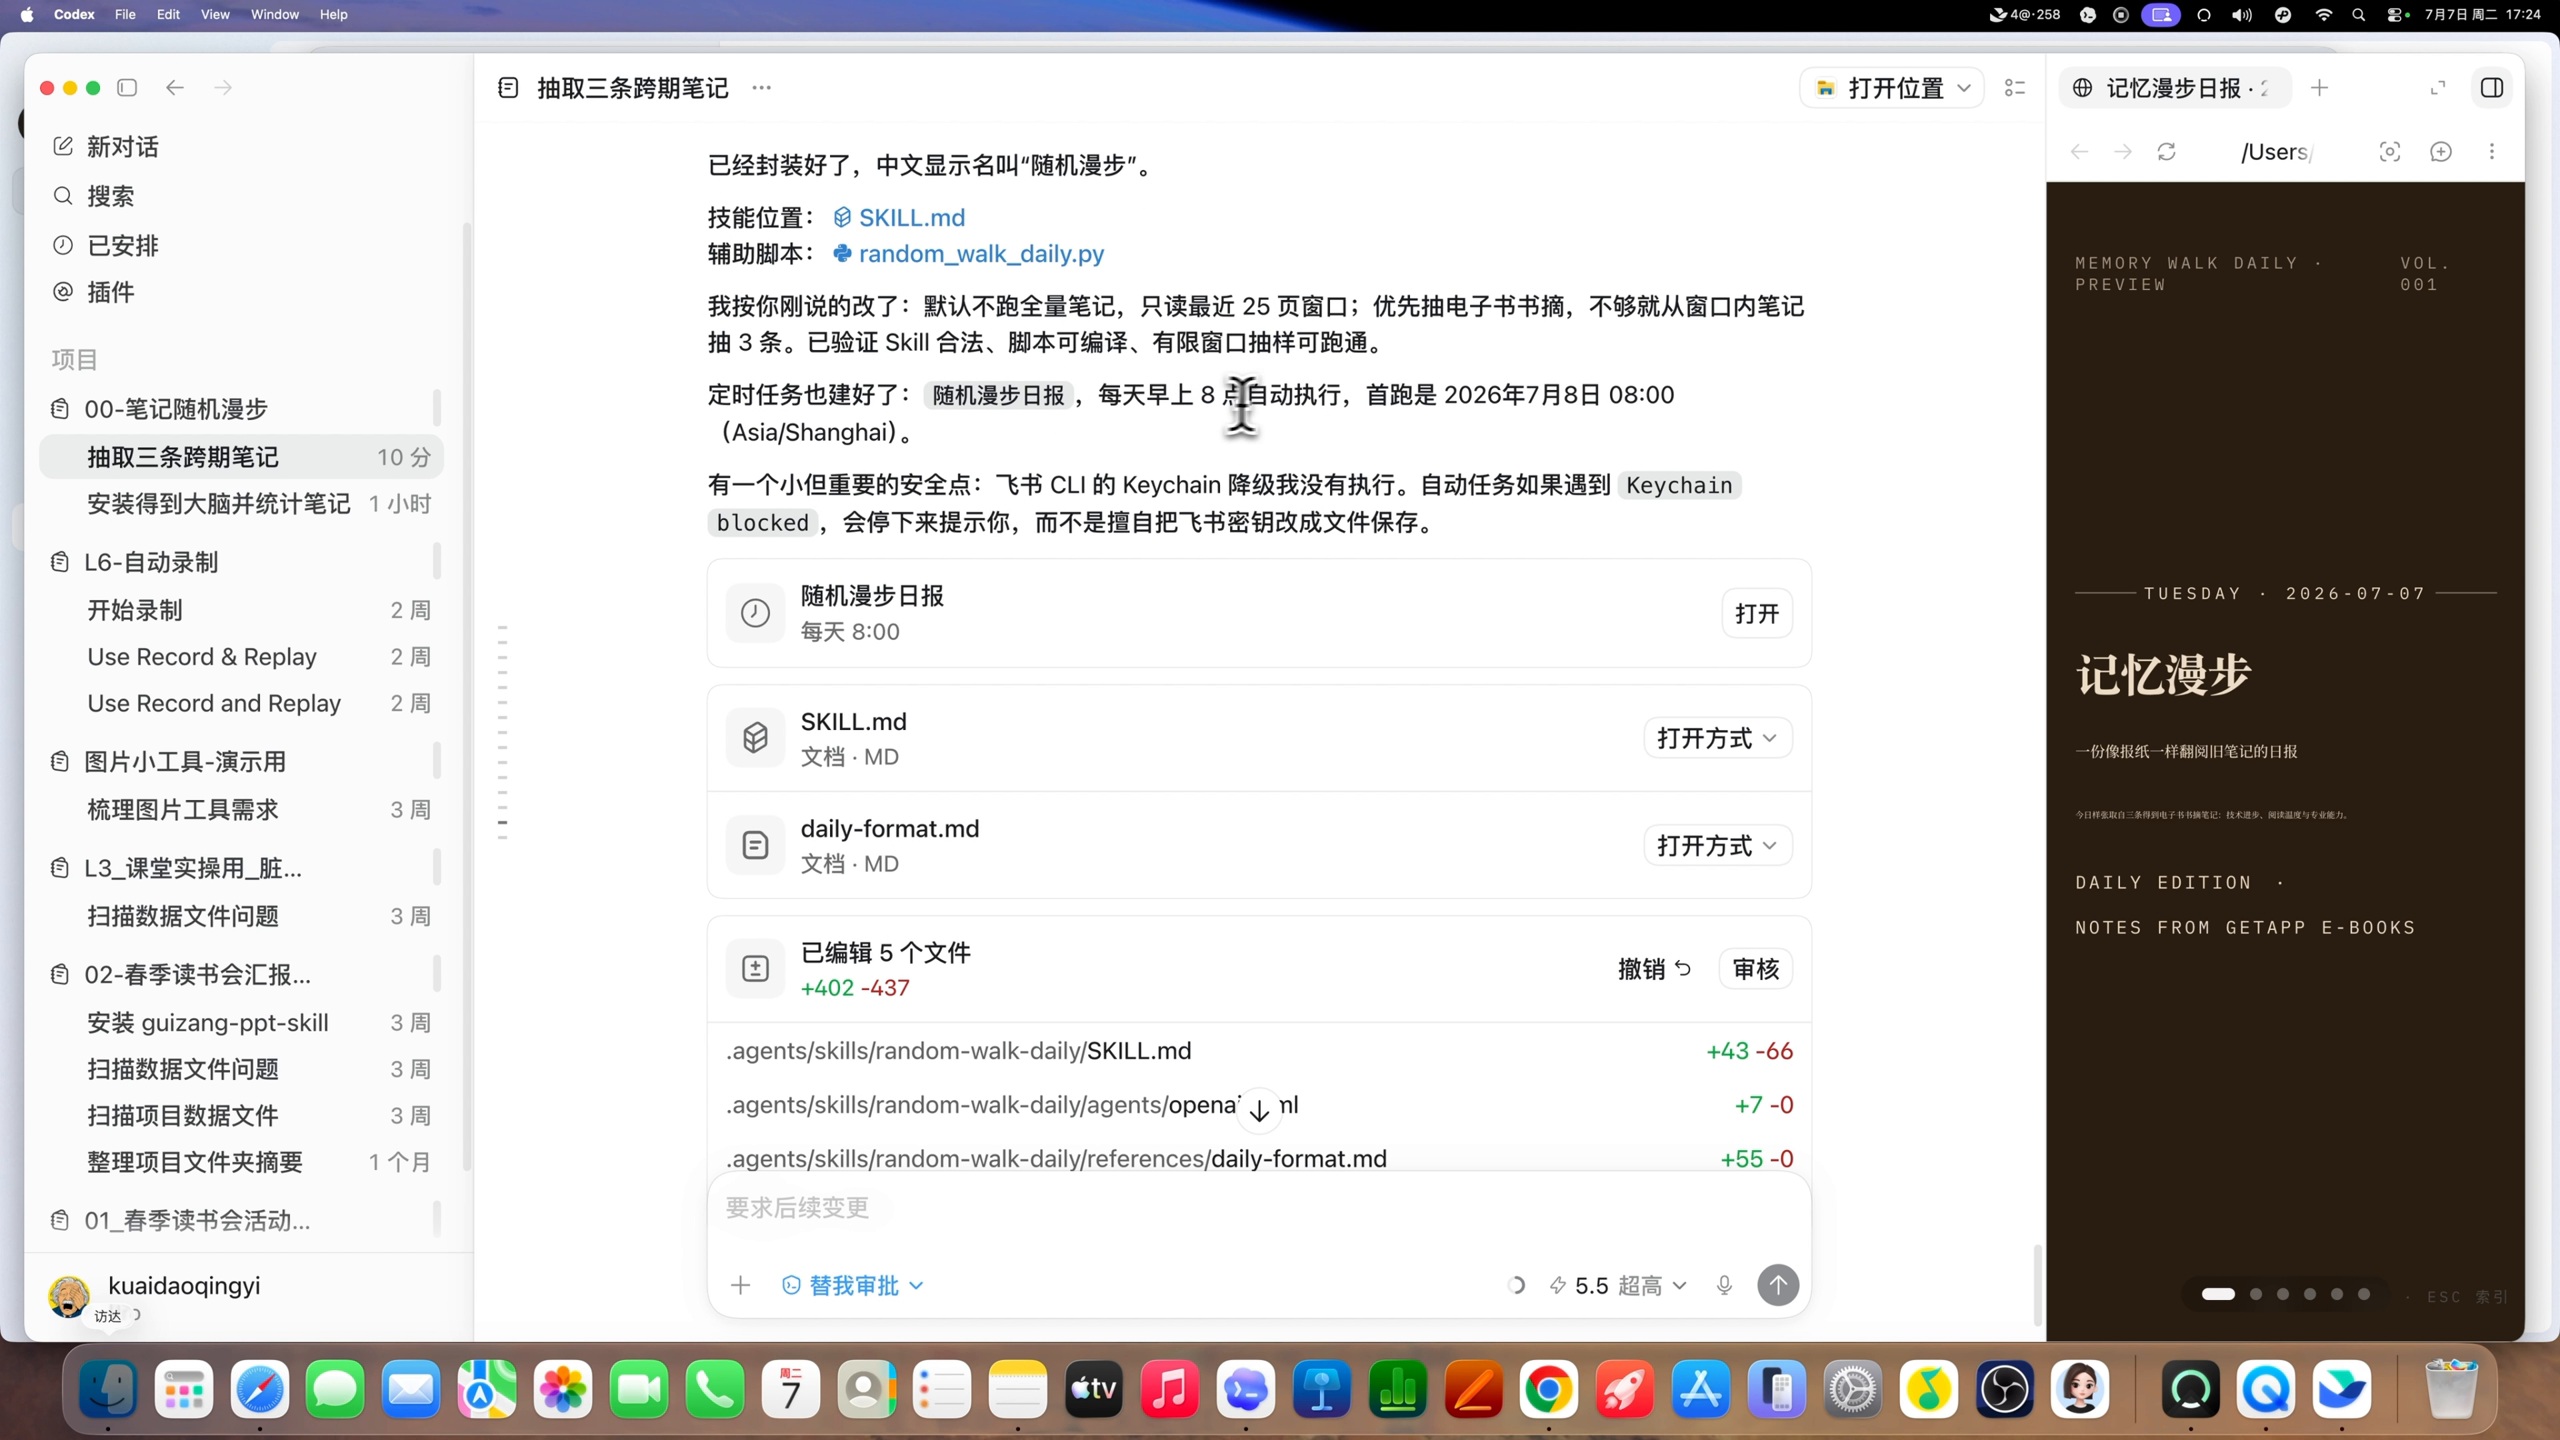
未来,你可以在不同任务或项目里创建各种定时任务。比如每天从得到大脑里生成回顾笔记,也可以每天从海量跨界AI论文里随机找一篇,用大白话翻译成报告。这样,你就相当于每天都有几个研究
团队,帮你持续生成报告、资料和工作成果。
这些定时任务可以在侧边栏的“已安排”里找到。点进去之后,可以看到刚才创建的“随机漫步日报”。
里面的规则可以编辑,模型难度可以调整,重复次数、执行频率也可以自定义。你也可以手动运行或暂停任务。
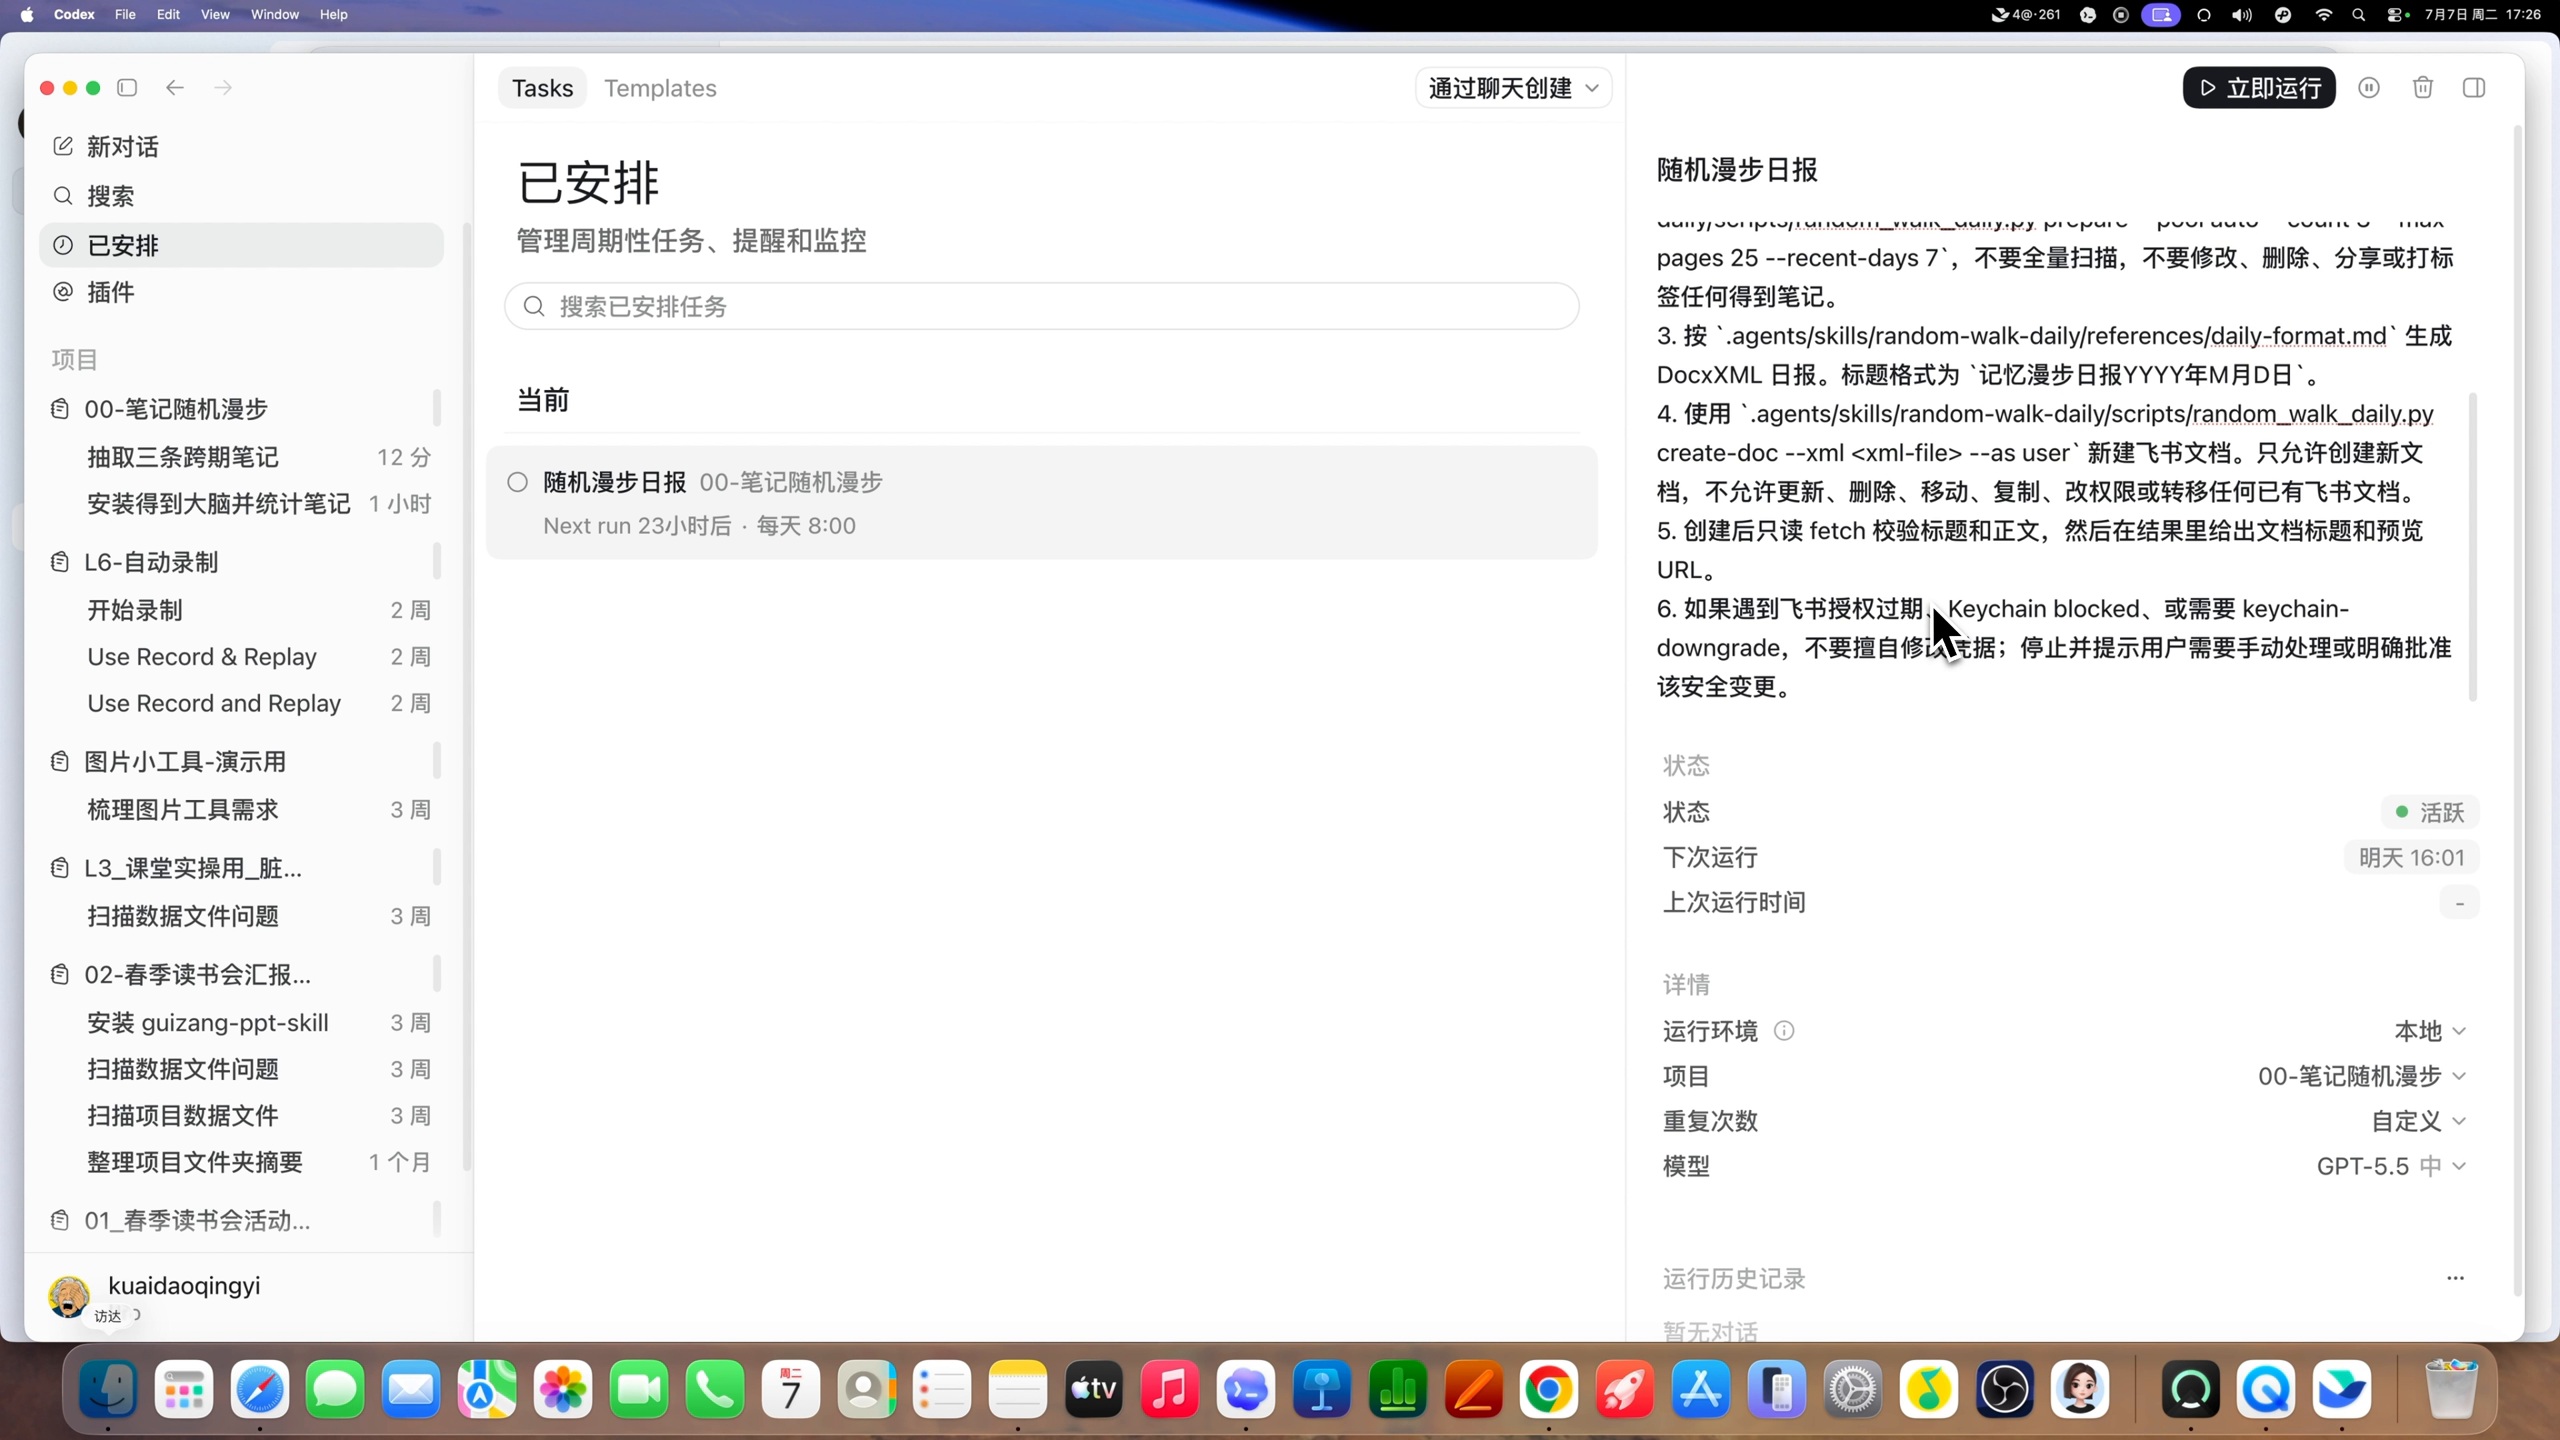
抓取某个行业的研究报告、财报变化,再形成一份摘要。这些都是AI很擅长的工作:搜索、收集、整理信息,并按照固定节奏输出。
所以,今天这个案例的核心目的,并不是让大家一笔一画照着“记忆漫步日报”这个功能来做,而是希望给大家一个启发:你自己的工作中,有哪些任务可以外包给AI?有哪些过去想象不到的任务,可
以通过定时任务变成每天自动完成的工作流?
这讲的作业,就是大家回去跑通自己的日报。它可以来自得到大脑的笔记,也可以来自文摘、论文、行业报告,或者任何你感兴趣的信息源。只要你把规则定好,就可以让AI每天给你一个定制化的提
醒和输出。
下一讲就迎来最后一讲。刚才这些还都是把AI用在自己的工作场景里。如果有些场景用得很好,我想分享给同事,把个体经验变成团队经验,应该怎么用Codex来做?下一讲,我会带大家继续看这个
问题。
我是快刀青衣,我们下一讲再见。