第 9 卷
场景1:课堂上突然跟不上了,怎么办
1.课堂当下(隐蔽求助)2. 课间5分钟(深度追问)
| p适用场景:课堂上随时快速跟进 | p适用场景:老师已下课,但10分钟后还有后续课程 |
|---|---|
| p操作技巧: | p操作技巧: |
| Ø在笔记软件中快速标注困惑点(如:“疑问:第二 | Ø追问细节: |
步到第三步如何展开?”)
“为什么对y³求导会得到3y²·dy/dx而不是3y²?”
Ø 输入精准问题:
Ø 让AI用类比解释:
“隐函数求导例题:从方程x² + xy + y³ = 0推导 “请用‘水管流速’比喻说明隐函数求导中dy/dx的意 dy/dx,请展示完整的链式法则展开步骤,特别是分母义。”
3y²的来源。”
Ø 生成记忆口诀:
Ø 秒速获取步骤解析:
“把隐函数求导步骤编成顺口溜,包含‘遇y先写立即对照补全笔记,跟上老师进度。dy/dx’等关键词。”
场景2:文科生快速上手编程
AI幻觉问题抽取:多数据集问题加载
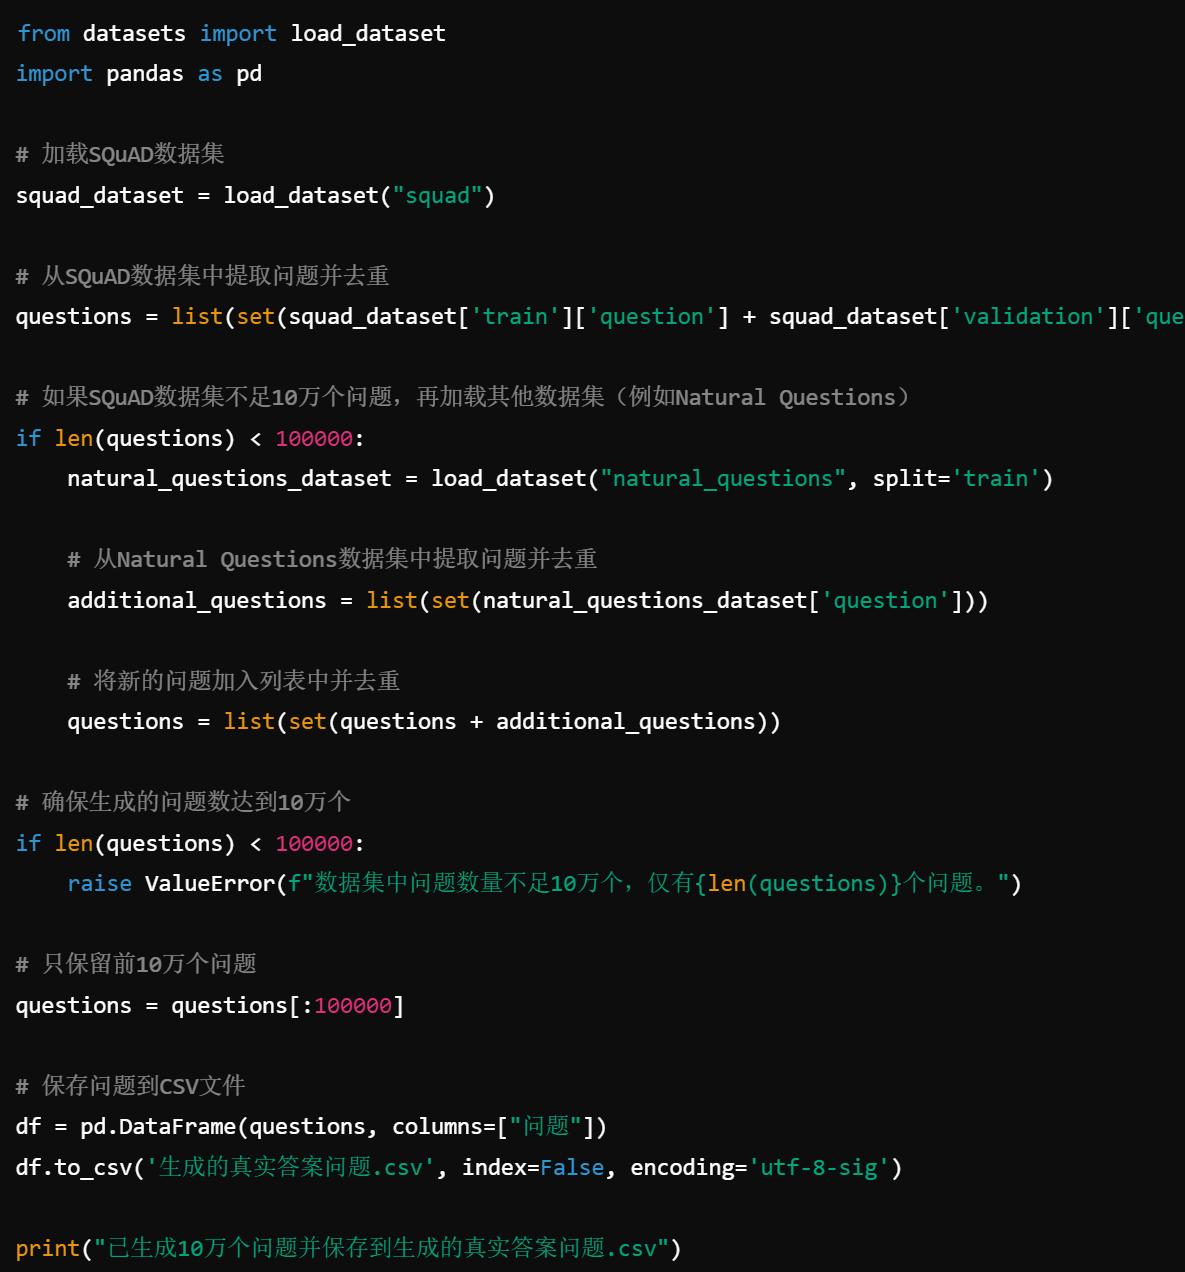

要生成10万个存在真实答案的问题,并且基于2020年之前的数据,可以使用现有的公开问答数据集(如S Q u A D、
Natural Questions等)来生成问题。可以从多个数据集中组合问题,以达到10万个的问题数量。
这些数据集包含大量的问答对,例如使用d a t a s e t s库(Hugging Face的datasets库)来加载SQuAD数据集
(Stanford Question Answering Dataset),这个数据集是一个著名的问答数据集,基于维基百科数据生成,并且数
据是2020年之前的。
加载数据集:使用datasets库加载SQuAD数据集,这个数据集包含了大量基于2020年之前数据生成的问答对。
提取问题:从数据集中提取问题,并使用set去重。
检查问题数量:确保提取的问题数量至少为10万个。
场景3:多智能体在线社区模拟
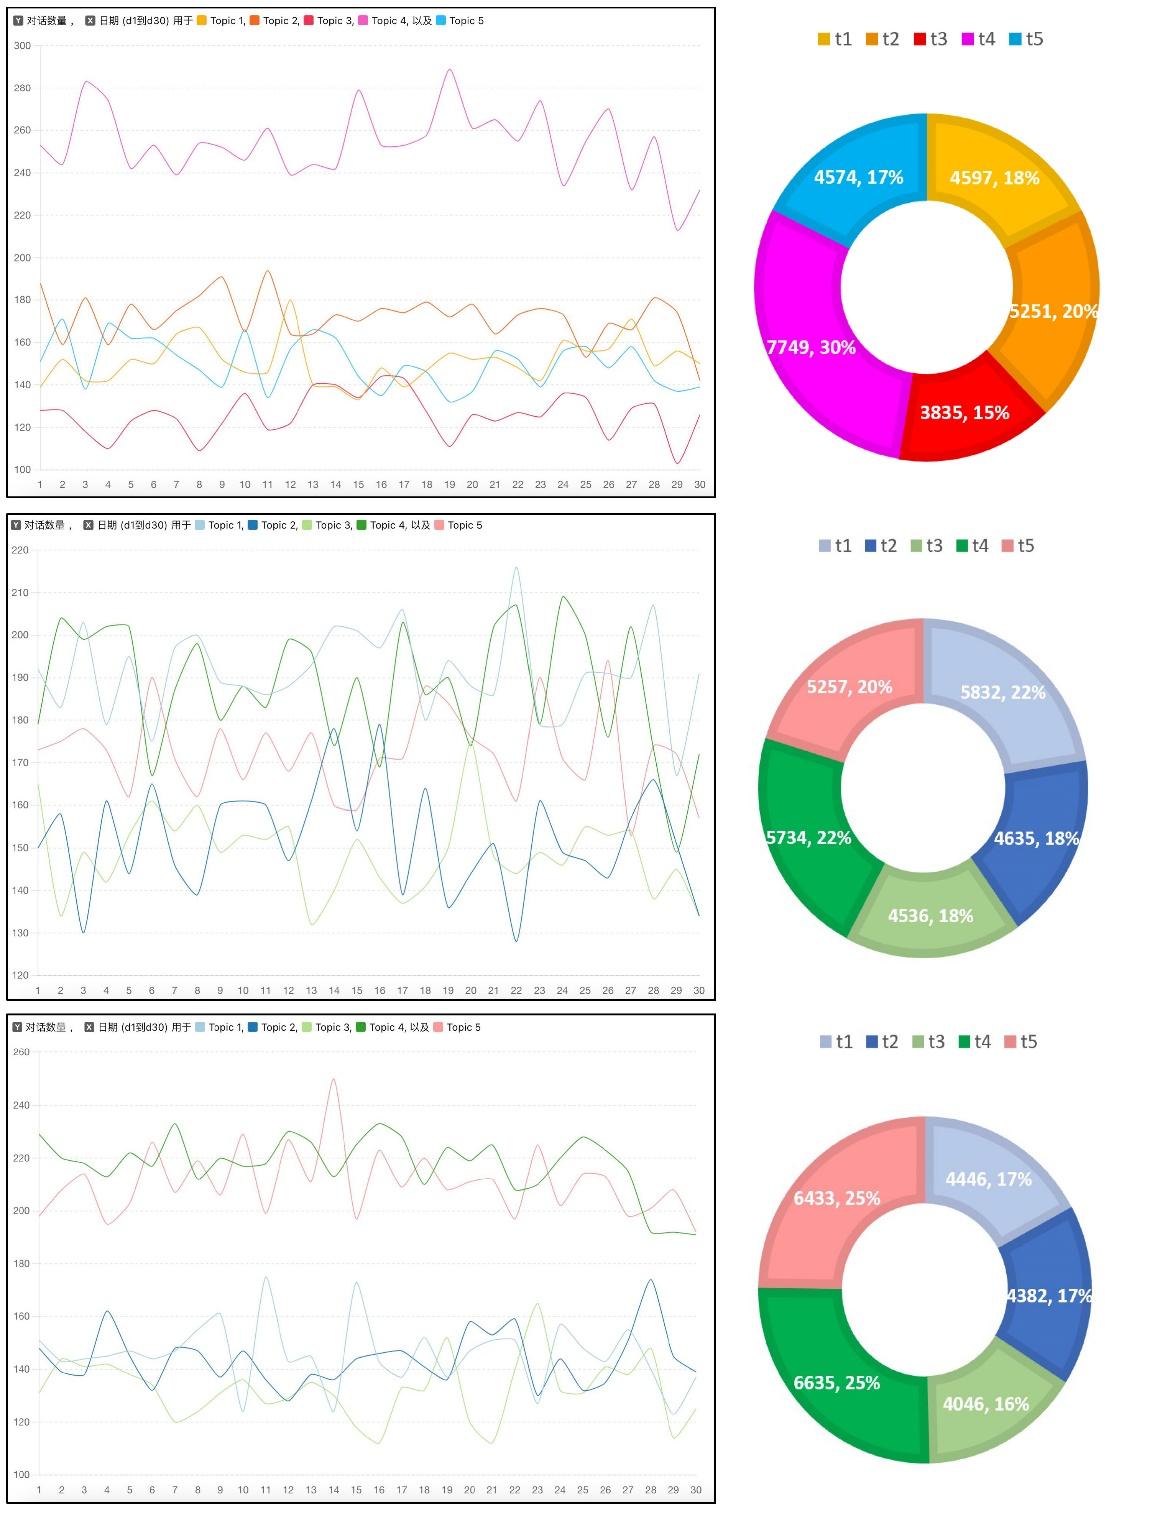
探讨大语言模型(LLMs)在模拟人类意见动态和社会现象(如极化和错误信息传播)中的表现,特别
是引入偏误信息后的意见动态变化。使用大模型模拟多个虚拟代理,讨论“气候变暖”、“转基因食
品的安全性”和“疫苗的有效性和安全性”三个具有科学共识的话题。
实验一在无偏误信息条件下,代理通过社交网络进行每日对话,记录最终信念状态和信息传播路径。
实验二改变初始信念分布,探讨初始条件对结果的影响。实验三引入10%代理发布的偏误信息,观察
其对信念动态的影响。50个代理人在30天内共生成 194699条对话。