第 17 卷
AI的内容生成的边界如何判断
研究将智能体知识循环边界操作化为生成内容的差异值,衡量标准为生成文本的平均相似度与重复率的加权值。
| 相似度计算 | 重复率计算 |
|---|---|
| 采用余弦相似度算法,将文本转化为词频向量,计算向量点积 | 使用n-gram方法(n=2),将生成文本分为连续的2-gram片 |
| 与模长乘积的比值,评估文本间的相似性,取值范围为[-1, 1], | 段,统计重复片段的比例。这个方法能够识别文本冗余信息并 |
| 值越接近1表示相似性越高。该方法广泛应用于信息检索和自 | 评估内容多样性,特别适用于长文本生成。 |
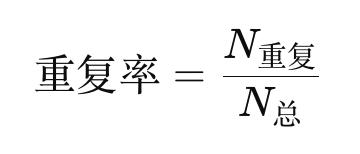
然语言处理领域,可有效评估文本内容的相似程度。
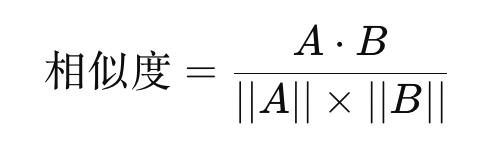
最终智能体知识循环边界公式如下。其中,权重w1=0.6,w2=0.4,参考Kleinberg (1999) 的社交网络分析研究,强调相关性优先于冗余性。这一配比平衡了生成内容的创新性与冗余性,为AI生成
文本质量的评估提供了量化依据。
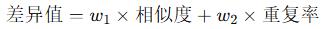
结合自适应反馈和递进式提示链让AI生成优质内容
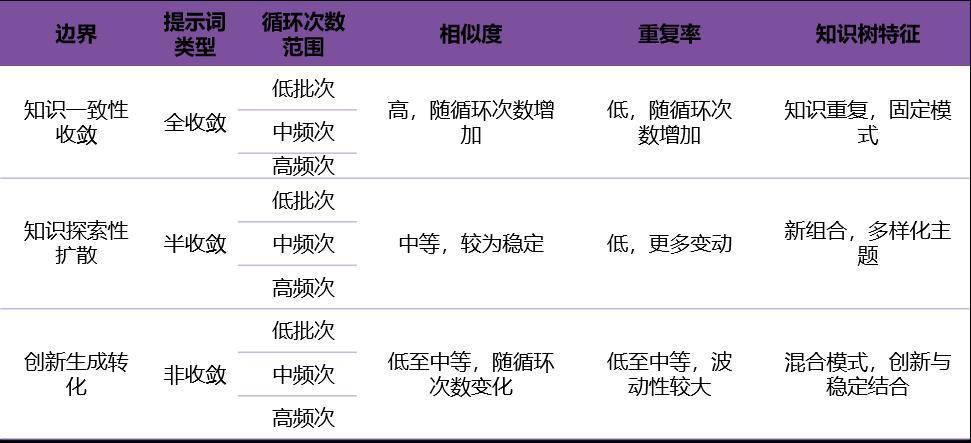
智能体认知循环边界并非终点,而是人类探索未知领域和创造新价值的起点。研究提出基于“自指性”和“循环性”的测量
机制,识别智能体生成内容触及边界的临界点,为优化生成内容提供量化依据。这一框架可扩展至多模态生成系统,并在教
育、科研和创新领域推动知识生成模式从常规化迈向创新化。
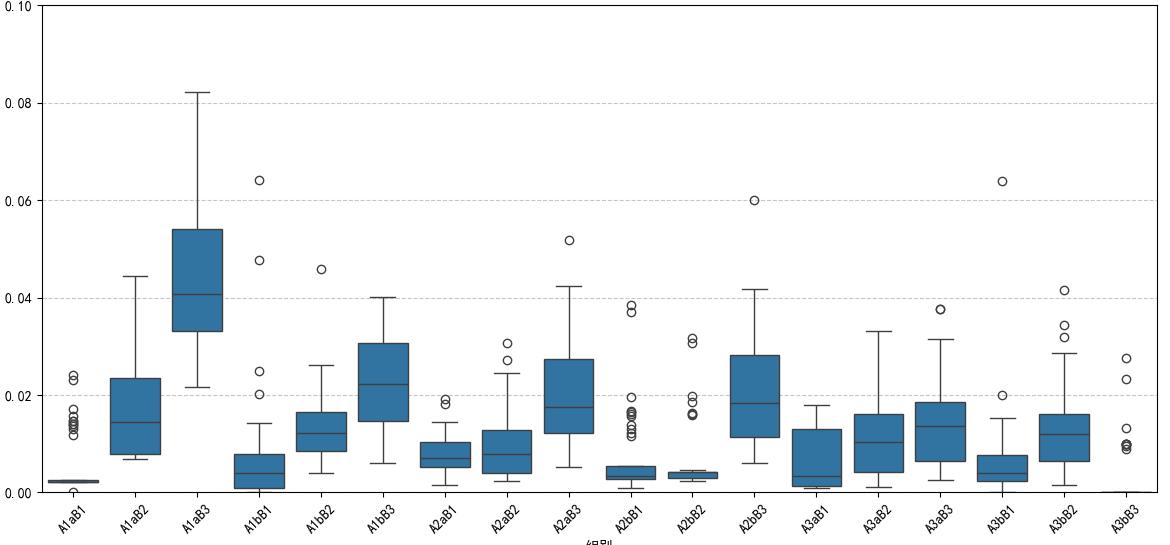
多轮交互中,智能体容易触及认知边界,表现为生成内容的固定化和信息增量的终止。实验显示,高收敛性提示语导致内容
趋于一致,而非收敛性提示语和多样化设计能突破逻辑循环。
结合自适应反馈和递进式提示链,可推动智能体生成新内容,避免知识循环,拓宽智能体的生成空间,为人机共生系统中的
深层交互与创新实践提供新路径。
结合自适应反馈和递进式提示链让AI生成优质内容
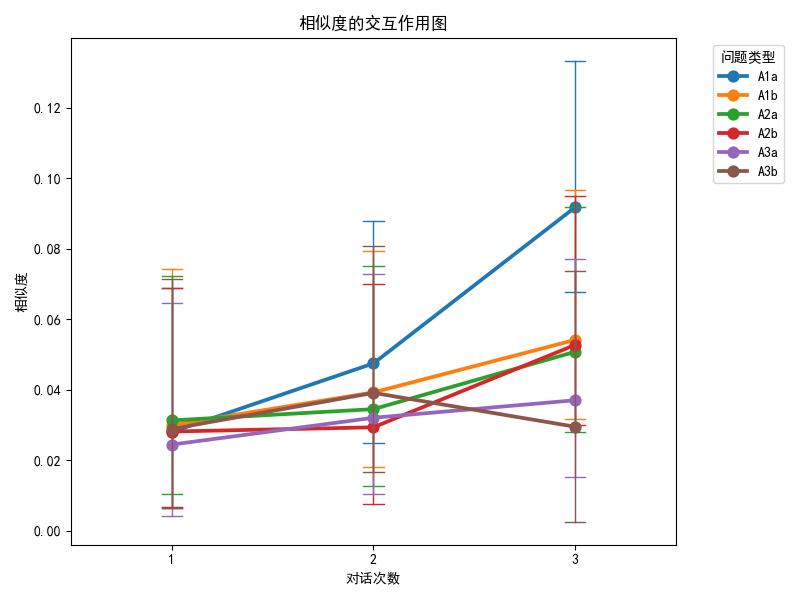
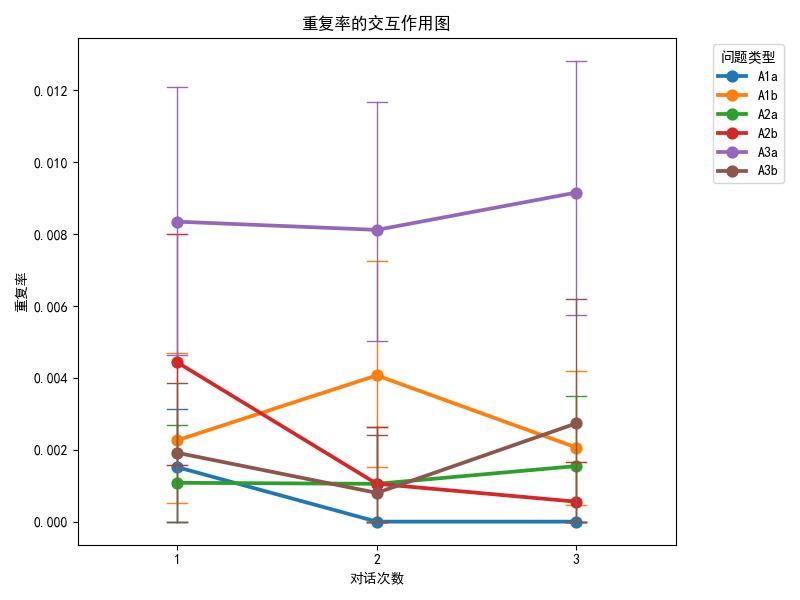
p 当AI面对收敛性高的提示词时,生成内容趋于一致,主要依赖已有知识的重复和组合。提示词的收敛性和对话轮次共同影响生成内容的相似度和重复率,收敛性较高的提示词会增加生成内容的一致性,而对话次数的增加促使AI生成文
本逐渐趋向固定模式。
p 在非收敛性提示词下,AI展现出更多的多样性和创新性,超越现有知识框架,尝试生成新的组合。问题类型对生成文本的重复率有显著影响,但对相似度的影响不明显。重复率的变化更多受到提示词的影响,而相似度的变化则主要源
于问题类型以外的其他因素。
p 通过调整提示词收敛性和对话轮次,AI从依赖已有知识的固定模式向创新性生成内容逐步转变,显示提示词设计和交互频率的影响力。