第 1 卷
张嘉熙 · DeepSeek Harness 前沿工程实践


你好,我是张嘉熙。
前面三讲,我们一直在跟一个会话打交道:它怎么落盘、断了怎么接上、装不下了怎么压短。
但真实的 Agent 用起来,会话从来不是一个,而是几十上百个会话散在各处,这时候新问题就冒出来了:
这些会话有的还在内存里、有的早就躺在磁盘上,要怎么读?
怎么搜出“聊过 X”的那个会话?
fork 出去的会话,怎么追它的父子关系?
三个问题,一个问“怎么读”,一个问“怎么搜”,一个问“怎么追”,答案都来自同一个服务:
ctx.sessionQuery(会话查询)。本讲前四节就是这三问的展开:读归一个逻辑语料库上的四个读方法,搜归全文搜索加精确过滤,追归谱系追踪。四节之后,末尾还有一件收尾的
@deepseek-ai/dsh-session-title(标题折叠,是 session-query 的 peer 依赖,本讲不展开),已加入本项目的 package.json,npm install --legacy-
peer-deps 装上即可。
关于示例:本讲四个示例各对应一节——npm run start:ch11:corpus(四个读方法)、start:ch11:search(全文搜索)、start:ch11:filter(精确过滤)、
start:ch11:lineage(谱系追踪)。四个示例都把索引放在内存数据库里,跑完即弃,不写磁盘。其中 search、filter 会跑全文搜索,Node 在第一次搜索时会往 stderr 打
两行 SQLite 实验性警告(一行 ExperimentalWarning、一行 --trace-warnings 提示);corpus、lineage 不碰搜索,不会出现。不影响结果。
逻辑语料库:内存优先,四个读方法
第一个问题:同一个会话,按 id 去读,该读内存里那份还是磁盘上那份?
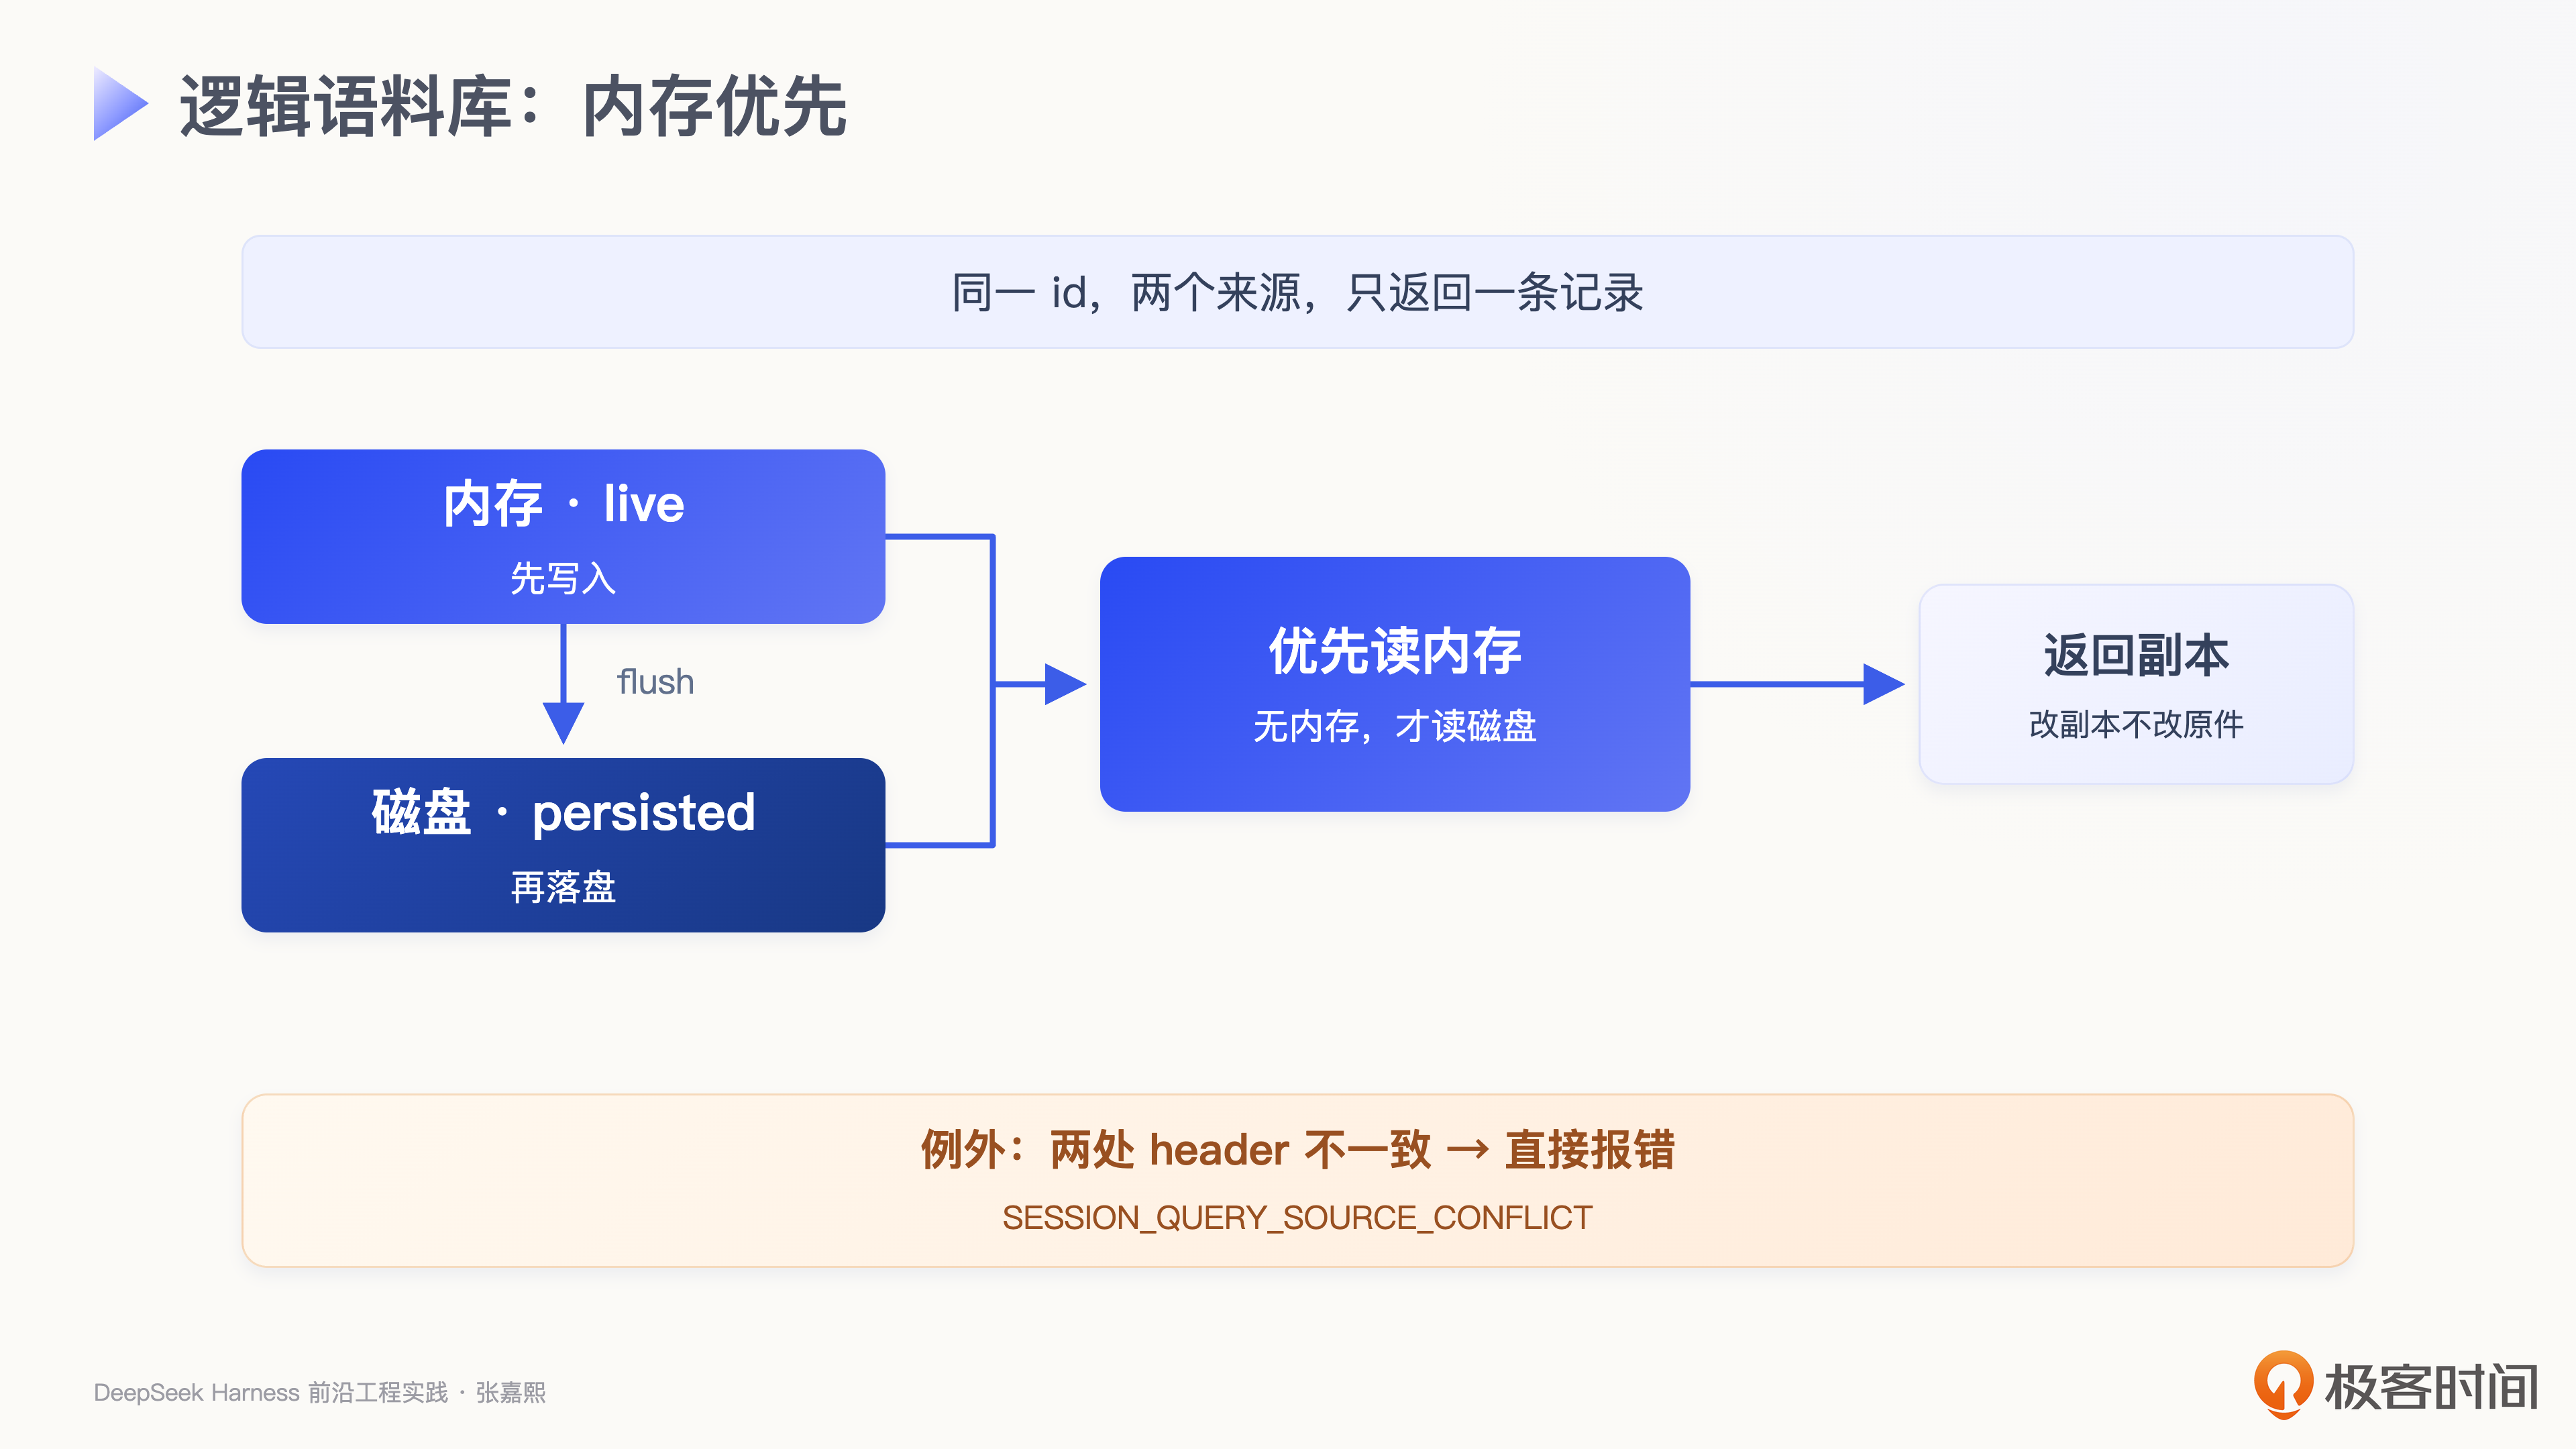
一个会话可能同时在两处存在:内存里一份活的(live),由进程持有、随时能往里追加(此刻也可能正空闲);磁盘上一份存档的(persisted),进程重启后能读回来。
这两处是同一串事件的两个存放处,不是缓存关系。
乍一看很像缓存:读的时候先查内存、查不到再去磁盘,行为上跟“先查缓存、再查源”一模一样。但缓存是源的只读副本,永远不会比源更新。这里恰恰相反:写操作先落内存,再 flush
到磁盘,所以内存里可能存着磁盘上还没有的新事件(第 09 讲:轮次开着时权威状态在内存里)。
后面我们直接叫这两处“内存”和“磁盘”;代码里对应的名字是 live 和 persisted(字段名、过滤器取值都用这两个词)。
你只需要按 id 查询,不用关心这个会话当前在内存里还是已经落到磁盘。查询服务会把两处的所有会话合并成一份逻辑语料库,物理上数据还散在两处,但逻辑上只有一份,位置差异对
复制代码 1interface SessionRecord {
| 2 | header: SessionHeader | //会话元数据:id、cwd、parentSession……(第09讲讲过的那个) |
|---|---|---|
| 3 | live:boolean | //现在在内存里活着吗 |
| 4 | persisted:boolean | //能从磁盘读回来吗 |
| 5 | } |
live 和 persisted 这两个字段可以同时为真:一个会话能既活着、又落过盘。但读的时候只取一处,内存有就读内存,没有才读磁盘,这就是内存优先。不过“优先”只管事件内容:两
处那份不可变的 header 若对不上,不会取谁优先,而是直接以 SESSION_QUERY_SOURCE_CONFLICT 失败。
所以只要有一个来源在,查询就能工作:没装持久化,内存里的活会话照样能查;一个会话都没在跑,磁盘上的存档也能直接读出来。两个都没有,才真的查不到。
而且读出来的都是副本:改你手里的这份,内存里、磁盘上的原件一个字节都不会动。